Programación autónoma con IA local: ¿bastan 8 GB de VRAM para programar con modelos de 30B?
¿Puede una tarjeta gráfica de solo 8 GB ejecutar modelos locales de 26, 30 o incluso 35B para programar de forma autónoma? ¿Y cuánto se gana añadiendo una segunda GPU de 6 GB comprada por poco más de 100 €?
Esta prueba busca responderlo con datos reales.
No se trata de pedirle a un chatbot que escriba un programa y copiar la respuesta. Aquí el modelo trabaja dentro de un agente de programación: recibe una tarea, analiza lo que tiene que hacer, escribe archivos, ejecuta código, observa los resultados, corrige errores y vuelve a intentarlo hasta completar el trabajo o alcanzar los límites establecidos.
La prueba se realizó primero utilizando una RTX 2080 SUPER de 8 GB. Después se añadió una RTX 2060 de 6 GB, una tarjeta que puede encontrarse en el mercado de segunda mano por algo más de 100 €, y se repitieron las mediciones de inferencia para comprobar qué mejora real aporta esa segunda GPU.
El resultado es bastante más interesante que un simple aumento de VRAM: los 6 GB adicionales no convierten el sistema en una GPU de 14 GB, pero sí pueden producir aumentos de velocidad de entre aproximadamente un 39 % y un 98 % dependiendo del modelo.
Y, en determinadas cargas, eso cambia bastante la experiencia de utilizar IA local.
Resultados rápidos
Antes de entrar en la parte técnica, estos son los datos principales del experimento:
| Prueba | Resultado |
|---|---|
| GPU inicial | RTX 2080 SUPER 8 GB |
| Segunda GPU | RTX 2060 6 GB |
| VRAM física total | 14 GB |
| CPU | Ryzen 7 5800X |
| RAM | 32 GiB |
| Modelos principales | 26–35B, todos MoE |
| Tarea | Programación autónoma en Python |
| Modelos que completaron la tarea | 3 |
| Ejecuciones completas | 2 por modelo |
| Mejora de inferencia con la segunda GPU | +39 % a +98 % |
La segunda GPU no se añadió para «hacer que cupiera» un modelo concreto y detener ahí la prueba. Primero se comprobó qué podía hacer el sistema con 8 GB de VRAM y posteriormente se midió cuánto cambiaba el rendimiento al incorporar otros 6 GB.
1. Programar con un chatbot no es programar con un agente
Esta diferencia es fundamental para entender los resultados.
Un chatbot puede recibir:
«Créame una ruleta de la fortuna en Python.»
Y devolver un bloque de código. Eso es generación de código.
Un agente de programación funciona de otra manera:
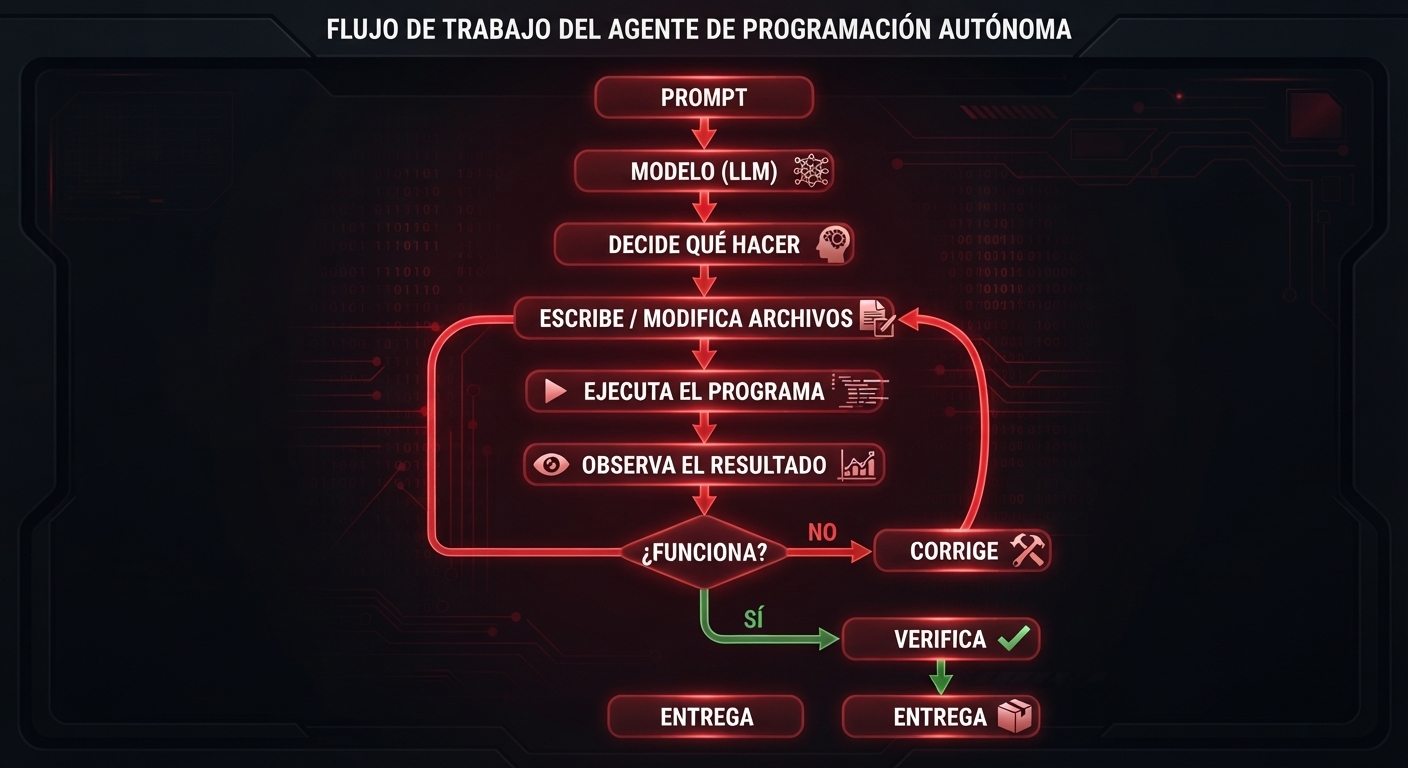
En este experimento, el modelo no trabaja aislado. El modelo es el componente que razona dentro de un sistema formado por:
- el modelo de IA;
- OpenCode;
- Agente Jiménez;
- herramientas de terminal;
- archivos reales del proyecto;
- ejecución del código;
- contexto acumulado;
- límites de tokens;
- límites de tiempo.
Por eso el rendimiento que interesa aquí no es solamente cuántos tokens genera una GPU por segundo. También importa cuántas vueltas necesita el agente para completar una tarea.
Un modelo que genera 20 tokens/s pero necesita 40 iteraciones puede tardar mucho más que otro que genera 15 tokens/s y resuelve la misma tarea en seis.
2. El hardware: primero 8 GB, después 14 GB
La primera parte de la prueba se plantea alrededor de una pregunta muy concreta:
¿Hasta dónde puede llegar una RTX 2080 SUPER de 8 GB cuando se utiliza para ejecutar modelos locales grandes en un agente de programación?
El equipo utilizado es:
| Componente | Configuración |
|---|---|
| CPU | AMD Ryzen 7 5800X |
| RAM | 32 GiB |
| GPU principal | NVIDIA RTX 2080 SUPER, 8 GB |
| GPU adicional | NVIDIA RTX 2060, 6 GB |
| VRAM total con ambas | 14 GB |
| Sistema operativo | Garuda Linux + KDE Plasma |
| Motor de inferencia | LM Studio / CUDA |
| Agente | Agente Jiménez |
| Coder | OpenCode |
| Lenguaje de la prueba | Python |
La prueba principal se centra en la RTX 2080 SUPER de 8 GB. Una vez obtenidos esos resultados, se incorpora la RTX 2060 de 6 GB y se vuelve a medir el rendimiento de inferencia con los mismos modelos.
La idea es sencilla: 8 GB → medir → añadir 6 GB → medir de nuevo.
De esta manera se puede separar la pregunta de capacidad de la pregunta de rendimiento.
3. ¿Cómo puede una GPU de 8 GB participar en la ejecución de un modelo de 35B?
A primera vista parece imposible. Un modelo de 35.000 millones de parámetros cuantizado a Q4 puede ocupar más de 20 GB en disco. La RTX 2080 SUPER utilizada en esta prueba solo tiene 8 GB de VRAM.
La explicación está en que el tamaño del archivo del modelo no equivale directamente a la cantidad de VRAM necesaria para procesar cada token.
El modelo no cabe íntegramente en los 8 GB de VRAM. Parte de sus pesos y/o estructuras necesarias para la inferencia deben permanecer fuera de la VRAM, en memoria del sistema, según la configuración de offload.
En los modelos utilizados en esta prueba entran en juego varios factores:
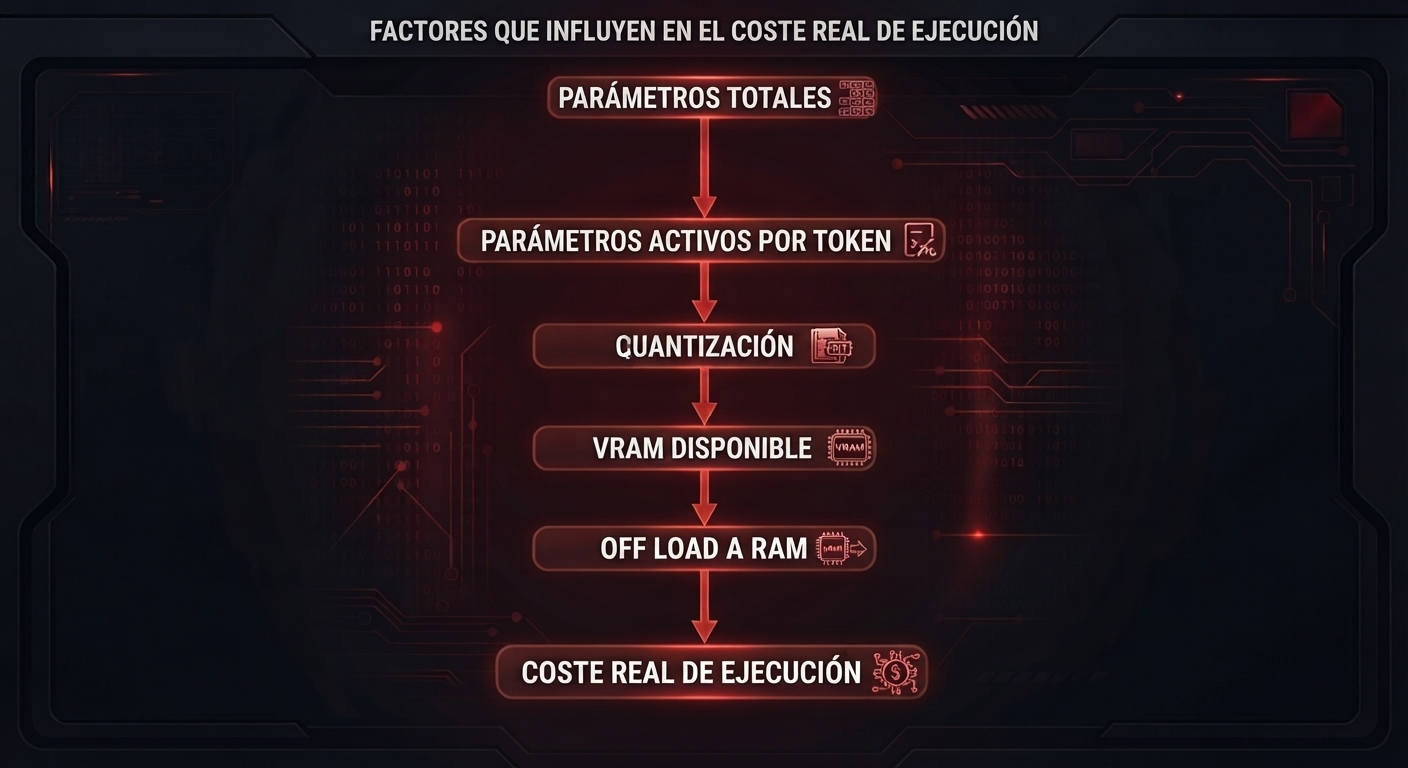
Los tres modelos que completaron la prueba son arquitecturas Mixture of Experts (MoE). Eso significa que un modelo puede tener decenas de miles de millones de parámetros totales, pero activar solamente una parte durante cada token.
Por ejemplo:
- 26B totales → aproximadamente 4B activos;
- 35B totales → aproximadamente 3B activos.
Esto cambia radicalmente el coste de inferencia. Un modelo Dense de 27B, en cambio, utiliza sus parámetros de manera mucho más completa durante cada token.
Además, cuando una parte del modelo no cabe en la VRAM, puede mantenerse en los 32 GB de RAM del sistema. El problema es que la RAM es muchísimo más lenta que la memoria de una GPU.
En este equipo se midió un ancho de banda real de RAM de aproximadamente 23–33 GB/s, que se convierte en uno de los principales límites cuando demasiado contenido tiene que salir de la VRAM.
Por eso dos modelos con tamaños similares pueden tener comportamientos completamente diferentes.
4. Los modelos utilizados
Estos tres modelos no se eligieron por ningún motivo especial de antemano. En los días previos a esta prueba probé individualmente más de una decena de modelos distintos en este mismo equipo. De todos los que llegaron a funcionar, estos tres me parecieron los más interesantes para ponerlos a prueba en un agente de programación completo — no son «los mejores del mercado» ni una selección representativa de nada, son simplemente los que, tras esa criba previa, tenía más sentido comparar aquí.
Dos ejemplos concretos de por qué se quedaron fuera otros candidatos: una variante cuantizada específicamente para el motor ROCm/AMD no llegó ni a cargar en este equipo (aquí se usa el motor CUDA, incompatible con ese empaquetado). Otra, una variante Whittle-MoE de 27B, sí cargaba y generaba con normalidad, pero producía APIs inventadas (tk.Window, que no existe en Tkinter) y comentarios en español con palabras corruptas — probablemente por una cuantización demasiado agresiva para ese tamaño de modelo.
Los tres modelos que completaron la prueba principal fueron:
| Modelo | Arquitectura | Parámetros | Activos aprox. | Cuantización | Tamaño |
|---|---|---|---|---|---|
| cyber-tiel-coder-35b-a3b | MoE | 35B | ~3B | Q4_K_S | 21,8 GB |
| google/gemma-4-26b-a4b-qat | MoE | 25,2B | 3,8B | Q4_0 QAT | 15,6 GB |
| zai-org/glm-4.7-flash | MoE | 30B | — | Q4_K_M | 18,1 GB |
Un detalle importante: los tres modelos que llegaron al final son MoE. También se probaron modelos Dense alrededor de 27B, pero ninguno consiguió completar la tarea bajo estas condiciones.
Esto no permite afirmar que «MoE siempre es mejor que Dense». Lo que sí permite decir es algo mucho más concreto:
En este hardware, con este agente, estos límites y esta tarea, los modelos MoE fueron los que consiguieron completar el ciclo de programación autónoma.
5. La tarea: una ruleta de la fortuna
La tarea elegida deliberadamente no es un proyecto enorme. Precisamente por eso resulta útil.
No hace falta un proyecto grande para poner a prueba a un agente de programación. Detrás de «una ruleta con Tkinter» hay varias dificultades pequeñas pero reales que un modelo tiene que resolver todas a la vez, sin ayuda:
- Animar sin congelar la ventana. Un giro fluido exige apoyarse en el propio bucle de eventos (temporizadores tipo
after()) en vez de un simplesleep(), o la interfaz entera se bloquea mientras gira. - Una desaceleración creíble. No basta con detener la ruleta de golpe: hay que reducir la velocidad progresivamente, fotograma a fotograma, con algún factor de frenado.
- Calcular el premio ganador correctamente. Averiguar qué segmento queda exactamente bajo el marcador fijo, a partir del ángulo final de giro, es aritmética modular fácil de desplazar un segmento entero por un error de signo o de origen.
- Encajar el texto en cada segmento. Colocar el nombre de cada premio girado y legible dentro de su porción de tarta, sin que se salga ni quede ilegible.
- Gestionar el estado del botón. Desactivarlo mientras gira y reactivarlo al terminar, sin que se quede bloqueado si algo sale mal a mitad de la animación.
- Sin salirse de la librería estándar. Todo esto usando solo lo que trae Python de fábrica, sin dependencias externas, y entregando un programa que de verdad se pueda ejecutar tal cual.
Ninguna de estas dificultades es difícil por separado. Juntas, y resueltas de una sola vez sin intervención humana, son suficientes para separar a un modelo que «sabe escribir Python» de uno que además sabe terminar un programa que funciona.
Se pidió al agente crear una aplicación llamada ruleta.py, utilizando Python y una biblioteca gráfica nativa. La aplicación debía incluir:
- una ventana gráfica;
- una ruleta circular;
- ocho segmentos iguales;
- diferentes colores o colores alternados;
- el texto de cada premio;
- un marcador fijo;
- un botón «Girar ruleta»;
- animación fluida;
- velocidad progresivamente decreciente;
- selección del premio ganador;
- presentación del resultado;
- desactivación del botón durante el giro;
- reactivación al finalizar.
Los ocho premios estaban definidos directamente en el prompt. El prompt fue el mismo para los modelos. No se modificó la petición para ayudar a un modelo concreto. Tampoco se hicieron correcciones manuales durante el proceso.
Este es el prompt exacto, completo, tal como se envió a los tres modelos — cópialo y pruébalo tú mismo:
Quiero que desarrolles una aplicación con interfaz gráfica llamada ruleta.py.
Objetivo:
Crear una ruleta de la fortuna interactiva con 8 premios relacionados con AP.

Requisitos funcionales:

La aplicación debe abrir una ventana con una interfaz gráfica.
En el centro debe mostrarse una ruleta circular dividida en 8 segmentos iguales.
Cada segmento debe tener un color diferente o alternado para distinguirlos bien.
Cada segmento debe mostrar el texto de un premio.
Debe haber un indicador fijo, tipo flecha o marcador, que señale el premio ganador cuando la ruleta se detenga.
Debe haber un botón visible con el texto “Girar ruleta”.
Al pulsar el botón:
La ruleta debe empezar a girar.
Debe hacerlo con una animación fluida.
La velocidad debe ir disminuyendo progresivamente.
Finalmente debe detenerse en uno de los 8 premios.
Cuando la ruleta se detenga, debe mostrarse claramente el premio ganador en pantalla.
Mientras la ruleta esté girando, el botón debe desactivarse para evitar pulsaciones repetidas.
Cuando termine el giro, el botón debe volver a activarse.

Premios de la ruleta:

“Ganas una auditoría de privacidad del navegador”
“Ganas acceso al mapa mundial de receptores SDR”
“Ganas un tutorial para crear tu primera IA local”
“Ganas una guía para escuchar radio SDR desde cero”
“Ganas un análisis de tu huella digital online”
“Ganas acceso a herramientas de radio y señales”
“Ganas una guía para proteger tu identidad digital”
“Ganas recursos exclusivos del laboratorio Acuántico Power”

Usa python como lenguaje principal.
Usa una librería gráfica nativa de python.
El código debe estar organizado, ser legible y tener comentarios útiles.
Evita dependencias innecesarias.
La ruleta debe funcionar sin conexión a internet.
Si el proyecto necesita varios archivos, créalos con una estructura limpia.
Incluye instrucciones claras para ejecutar el programa.
La finalidad era comprobar cómo se comportaba cada modelo ante una tarea pequeña pero completa: crear, ejecutar, comprobar y terminar.
Y también pone a prueba geometría de verdad, no solo lógica de programa: dividir un círculo en 8 porciones exactamente iguales, calcular el ángulo de cada una y girar el texto de cada premio para que siga la orientación de su porción son cálculos trigonométricos concretos, no una plantilla que se pueda copiar sin entenderla. A eso se suma el efecto visual completo que hay que conseguir: que la ruleta gire, que se note cómo va perdiendo velocidad de forma progresiva hasta pararse —no de golpe— y que el texto de los premios gire pegado a la ruleta en todo momento, no fijo en la pantalla. Es la parte del prompt más fácil de describir mal o de simplificar, y donde más se nota si un modelo entendió la tarea de verdad o solo generó algo que se le parece.
Tampoco es casualidad qué tarea no se eligió. Deliberadamente no pedí un Tetris ni un Snake ni ningún otro clásico por el estilo. Ese tipo de proyectos aparece tantas veces en el entrenamiento de estos modelos — precisamente porque son los ejemplos típicos con los que se mide y se optimiza su puntuación en los benchmarks de programación más comunes— que un modelo puede resolverlos bien sin que eso demuestre gran cosa: puede estar reproduciendo algo memorizado, no razonando la tarea desde cero. Una ruleta con premios inventados y un prompt escrito para esta prueba concreta reduce esa ventaja y acerca el resultado a lo que ocurriría con cualquier encargo real que no esté ya resuelto mil veces en internet.
6. La misma tarea, con una GPU y con dos
Cada uno de los tres modelos principales completó la tarea dos veces, pero no en las mismas condiciones: la primera vez utilizando solo la RTX 2080 SUPER, la segunda vez con la RTX 2060 ya instalada junto a ella. A diferencia de la comparación de inferencia bruta de las secciones 9 a 15, esta es la comparación al nivel que de verdad importa para un agente autónomo: el pipeline completo, de principio a fin, con una GPU y con dos.
Los resultados fueron:
Antes de leer la tabla: el Tok/s de aquí abajo no es comparable con los porcentajes de mejora de las secciones 10-15. Son dos mediciones distintas —esta es la media dentro de un agente completo, aquella es inferencia directa— y más abajo se explica por qué no coinciden.
| Modelo | Ejecución | Verificado | Tiempo | Iteraciones | Tokens | Tok/s |
|---|---|---|---|---|---|---|
| Cyber-Tiel 35B | 1 (solo 2080S) | Sí | 38,1 min | 30 | 21.627 | 10,27 |
| Cyber-Tiel 35B | 2 (2080S+2060) | Sí | 42,4 min | 41 | 21.994 | 12,97 |
| Gemma 4 26B | 1 (solo 2080S) | Sí | 13,3 min | 14 | 10.628 | 15,14 |
| Gemma 4 26B | 2 (2080S+2060) | Sí | 4,2 min | 6 | 3.010 | 17,03 |
| GLM-4.7-Flash | 1 (solo 2080S) | No | 90,5 min | 49 | 26.751 | 4,69 |
| GLM-4.7-Flash | 2 (2080S+2060) | No | 90,3 min | 97 | 36.207 | 4,19 |
Las iteraciones son llamadas reales de generación registradas en los logs de LM Studio. No son estimaciones. Tampoco hubo rondas adicionales de reparación visual en ninguna de las seis ejecuciones.
Al ser una sola ejecución por configuración, esta tabla no permite hablar de consistencia estadística. Sirve para ver el efecto de la segunda GPU sobre la tarea completa, no para medir cuánto varía un modelo entre intentos idénticos.
Nota sobre la columna Tok/s: es la media de las velocidades de generación por llamada individual que registra LM Studio, no el resultado de dividir el total de tokens entre el tiempo total de la ejecución (que incluye reprocesado de contexto entre iteraciones).
7. Lo que muestran realmente estos resultados
Gemma 4 26B: muy rápido, con o sin segunda GPU
Gemma fue, en las dos configuraciones, el modelo que menos tiempo necesitó. Con la RTX 2080 SUPER sola tardó unos 13 minutos y 14 iteraciones; con la RTX 2060 añadida bajó a poco más de 4 minutos y solo 6 iteraciones. Es una diferencia considerable — pero con una sola ejecución por configuración no se puede saber con certeza cuánto viene de tener la segunda GPU disponible y cuánto es variabilidad normal del propio modelo entre intentos.
Lo que sí es un dato limpio: la velocidad de generación por llamada apenas cambió (15,14 → 17,03 tok/s). El tiempo total no dependió principalmente de generar más rápido, sino del número de vueltas que necesitó el agente para cerrar la tarea.
Esto demuestra algo importante sobre los agentes: la velocidad de generación no determina por sí sola la velocidad de finalización.
Cyber-Tiel 35B: más rápido por llamada, pero no más rápido en total
Cyber-Tiel necesitó bastante más tiempo que Gemma en ambas configuraciones: 38,1 minutos solo con la 2080 SUPER, 42,4 minutos con la 2060 añadida. El resultado es contraintuitivo: con la segunda GPU la velocidad de generación por llamada subió (10,27 → 12,97 tok/s), pero el tiempo total de la tarea fue mayor, no menor, porque esa ejecución necesitó más iteraciones (41 frente a 30) para un volumen de generación similar (21.994 frente a 21.627 tokens). El pipeline verificó el resultado en las dos ocasiones.
Esto confirma, con un ejemplo aún más claro, que volumen de generación y tiempo de finalización no deben confundirse con una única métrica de velocidad: más tokens por segundo no garantiza terminar antes. Con solo una ejecución por configuración no se puede hablar todavía de consistencia estadística.
GLM-4.7-Flash: el problema estuvo en cerrar el ciclo, con y sin segunda GPU
GLM es especialmente interesante. Duró aproximadamente 90 minutos en las dos configuraciones — 90,5 minutos solo con la 2080 SUPER, 90,3 minutos con la 2060 añadida — sin que la segunda GPU cambiara la conclusión: el pipeline no llegó a cerrar el ciclo en ninguna de las dos. Sin embargo, el programa generado era funcional en ambos casos. El problema no fue simplemente «no sabe programar». El problema estuvo en el comportamiento del agente.
En ninguna de las dos configuraciones el pipeline llegó a cerrar correctamente el ciclo dentro de sus propios límites. Hubo:
- 49 iteraciones solo con la 2080 SUPER;
- 97 con la 2060 añadida — casi el doble, en prácticamente el mismo tiempo total, coherente con la mejora de velocidad de inferencia medida para este modelo en la sección 10;
- 0 finalizaciones naturales (el modelo nunca llegó por sí solo a un punto de parada) en las 146 iteraciones combinadas.
Esto es importante porque muestra una diferencia que suele perderse en los benchmarks tradicionales: un modelo puede producir código válido y, aun así, no comportarse correctamente dentro de un agente autónomo — y tener una GPU más rápida no arregla ese problema, solo le permite intentarlo más veces sin éxito.
Revisando los registros de una de las ejecuciones aparece una pista de por qué costó tanto cerrar el ciclo: de las llamadas de edición registradas, 19 fueron sobre el propio ruleta.py y 18 sobre el archivo de test que el modelo decidió crearse por su cuenta — casi mitad y mitad. Buena parte del esfuerzo se fue en reescribir sus propios tests en cada vuelta, no solo en arreglar el programa; un patrón compatible con estar persiguiéndose la cola (ajustar el test al código, tocar el código, romper el test) en vez de converger hacia una versión que cumpliera ambos a la vez.
Solo con la 2080 SUPER hubo además un fallo distinto a todo lo demás visto en esta prueba: tras 39 minutos de progreso real —archivos escritos, tests corriendo, errores corregidos—, la conexión con el motor de inferencia se cortó en seco, sin ningún error previo en los registros. Con las dos GPUs esto no llegó a ocurrir en ninguna ejecución. No hay forma de confirmar la causa con los datos disponibles: podría ser presión de memoria, un fallo puntual de CUDA, un timeout de la conexión cliente-servidor o cualquier otra combinación, y sin logs del driver en el momento exacto del corte no se puede atribuir con certeza.
Hipótesis, sin confirmar: con un modelo de 18 GB exprimiendo una tarjeta de 8 GB, la presión de memoria es la explicación más razonable — un aviso más para quien valore montar un equipo de una sola GPU con modelos grandes: no solo puede ser más lento, también puede ser menos estable.
Para programación autónoma, saber cuándo continuar y cuándo terminar también forma parte del problema.
8. El código generado: no basta con que el agente diga «verificado»
El estado verificado debe interpretarse con cuidado. Significa que el pipeline consiguió completar su mecanismo de comprobación. No significa que el programa sea perfecto.
Por eso el resultado debe evaluarse también desde el punto de vista del programa generado. Los tres modelos produjeron una ruleta funcional con los elementos fundamentales solicitados.
Nota técnica: un fallo del pipeline puede parecer un fallo del modelo
Durante esta investigación se encontró y corrigió un bug real en la propia tubería, y conviene mencionarlo porque cambia cómo hay que leer un resultado «no verificado». El presupuesto de tokens de cada llamada se reparte entre lo que el modelo puede generar como respuesta y lo que puede recibir como contexto de entrada. Una configuración inicial reservaba demasiado para lo primero: de un contexto de 29.952 tokens, 20.480 se apartaban para la salida, dejando solo unos 9.500 para la entrada — menos de lo que ocupa un solo reintento típico de este pipeline (~15.000 tokens, entre el archivo actual y el informe de verificación). El resultado era que varios reintentos fallaban ya en su primer turno, antes incluso de que el modelo pudiera ver por qué había fallado el anterior — algo que, visto desde fuera, se parece mucho a «el modelo no da la talla».
Esto no cambia ninguno de los resultados publicados en este artículo — se corrigió antes de las ejecuciones que forman esta comparación —, pero es un recordatorio útil: cuando un modelo local no converge dentro de un agente autónomo, vale la pena revisar primero la tubería antes de concluir que el problema es el modelo.
Cyber-Tiel
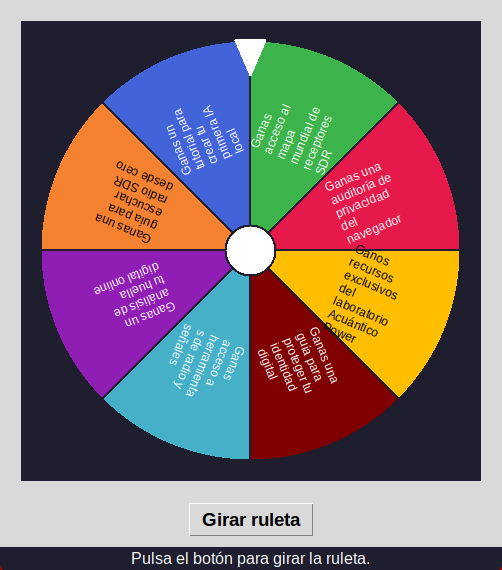
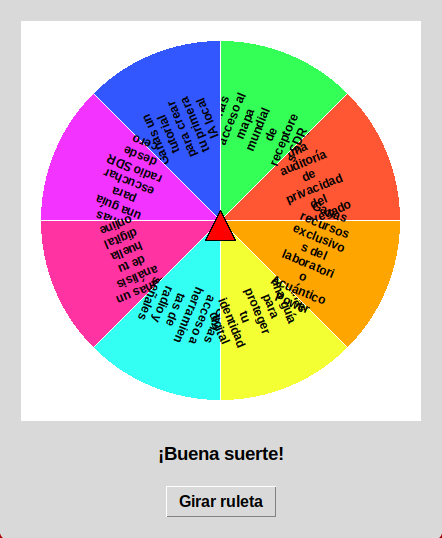
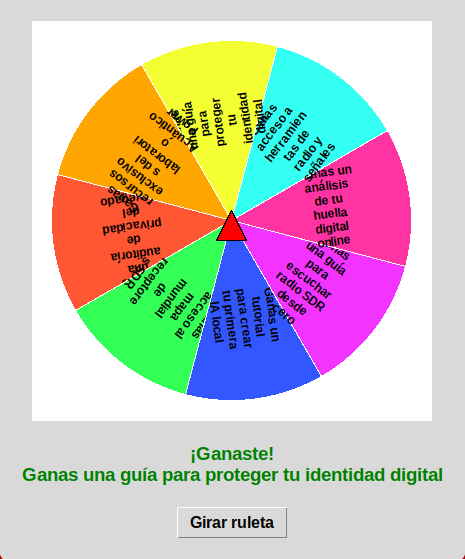
La implementación utiliza una clase RuletaFortuna, dibuja los segmentos con create_arc y utiliza root.after() para realizar la animación sin bloquear la interfaz. También incorpora un factor de desaceleración de aproximadamente 0.985 y una función específica para adaptar el contraste del texto según el fondo.
Encontré un pequeño error de transcripción en uno de los premios: aparece «Ganos» donde el prompt indicaba «Ganas». Es un fallo menor, pero demuestra por qué verificar el resultado sigue siendo importante incluso cuando el agente declara que ha terminado.
Captura real — Ejecución 1 (solo 2080S):
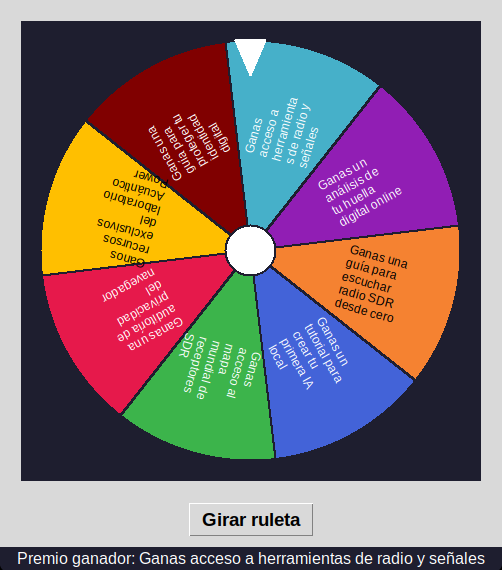
Captura real — Ejecución 2 (2080S+2060):
Gemma 4
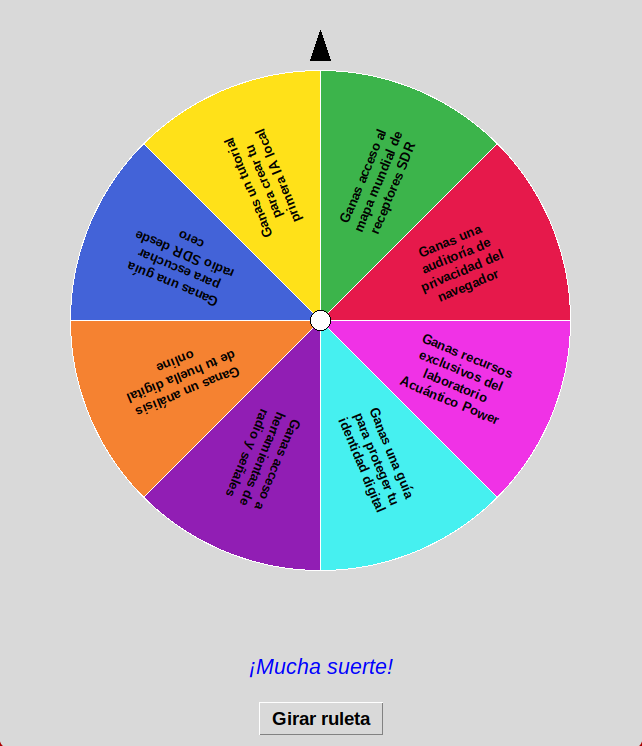
Utiliza una estrategia muy parecida: segmentos mediante pieslice, animación mediante after(), desaceleración progresiva, interfaz gráfica, botón de giro, selección del premio.
Los premios están correctamente transcritos. Su implementación es más sencilla y no incluye la lógica de contraste utilizada por Cyber-Tiel.
Captura real — Ejecución 1 (solo 2080S):
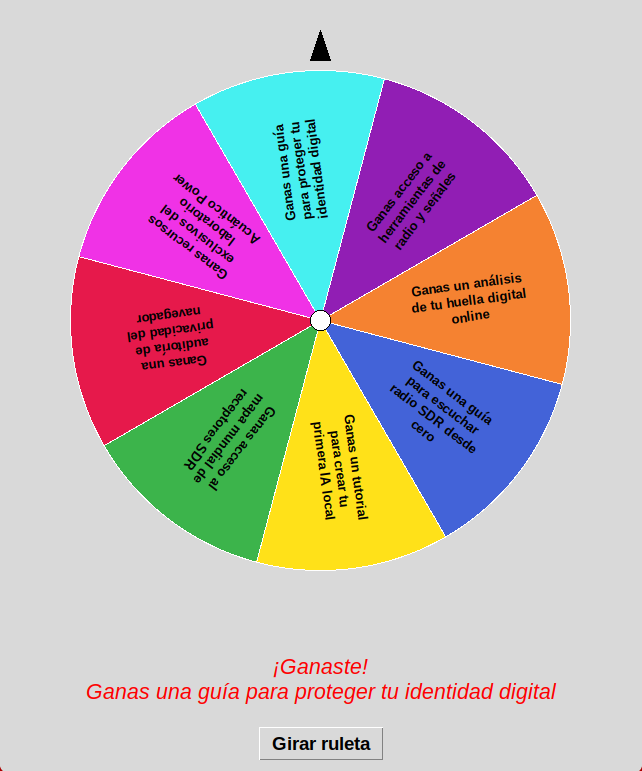
Captura real — Ejecución 2 (2080S+2060):
GLM-4.7-Flash
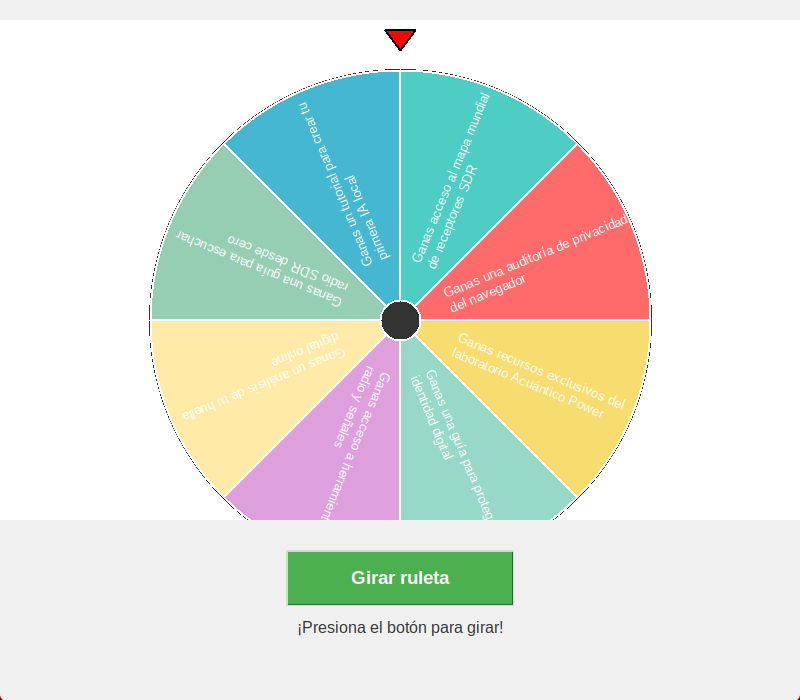
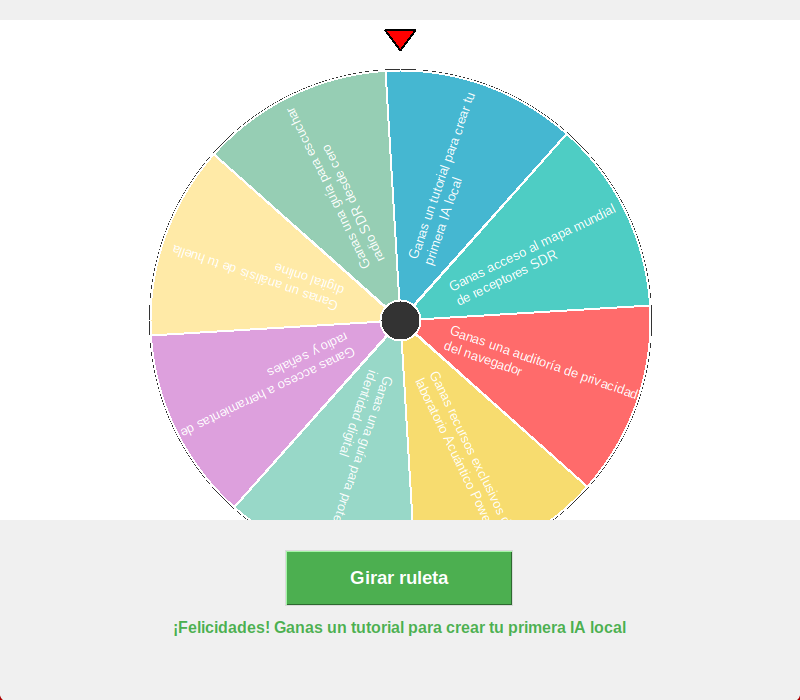
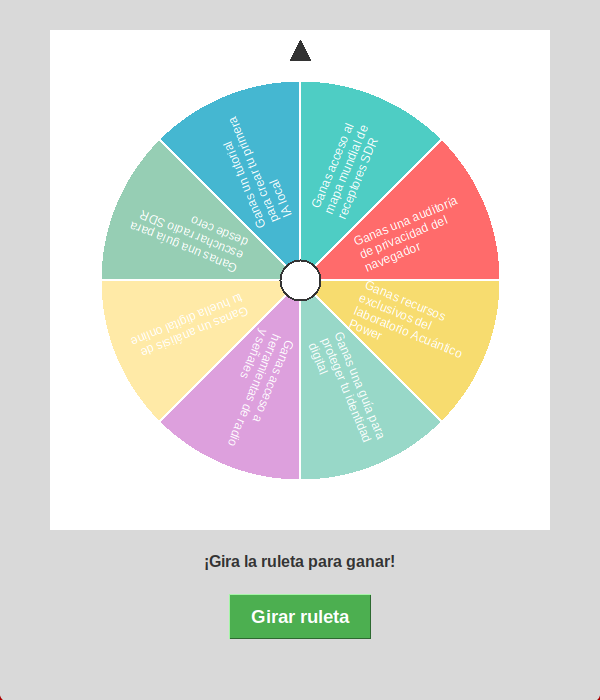
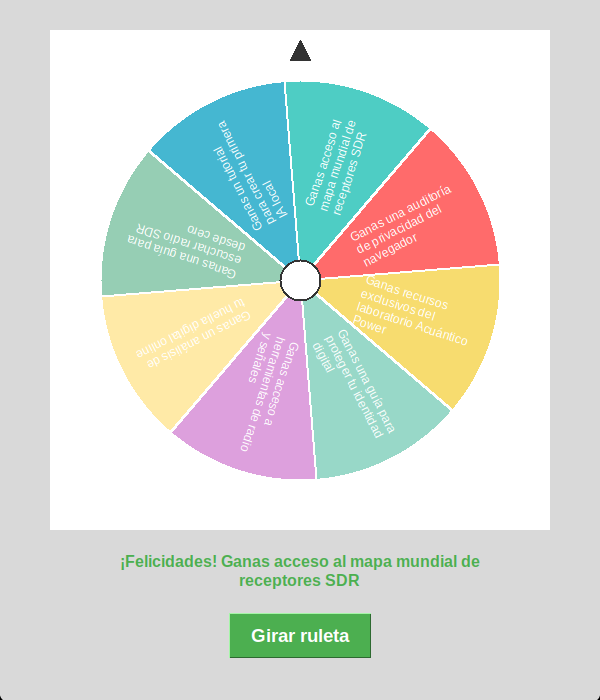
Su programa también resultó funcional. La estructura separa la creación de widgets y el dibujo de la ruleta y mantiene una interfaz gráfica razonablemente organizada.
Lo interesante es que el código funcionó aunque el agente no consiguiera finalizar correctamente el proceso de verificación. Esto vuelve a demostrar que «no verificado» y «código roto» no son sinónimos.
Captura real — Ejecución 1 (solo 2080S):
Captura real — Ejecución 2 (2080S+2060):
9. La segunda GPU: la prueba que realmente interesa
Hasta aquí tenemos una RTX 2080 SUPER de 8 GB como referencia. La siguiente pregunta es mucho más práctica: ¿qué ocurre si añadimos una segunda tarjeta gráfica barata?
La tarjeta elegida fue una RTX 2060 de 6 GB. El objetivo no era construir una estación de trabajo de miles de euros. La idea era mucho más sencilla:
¿Puede una GPU usada de poco más de 100 € aportar una mejora apreciable a un sistema que ya tiene una RTX 2080 SUPER?
Para comprobarlo se midió la inferencia directamente con LM Studio antes y después de añadir la RTX 2060. En esta segunda medición se utilizaron los mismos modelos.
10. RTX 2080 SUPER frente a RTX 2080 SUPER + RTX 2060
Los resultados son claros:
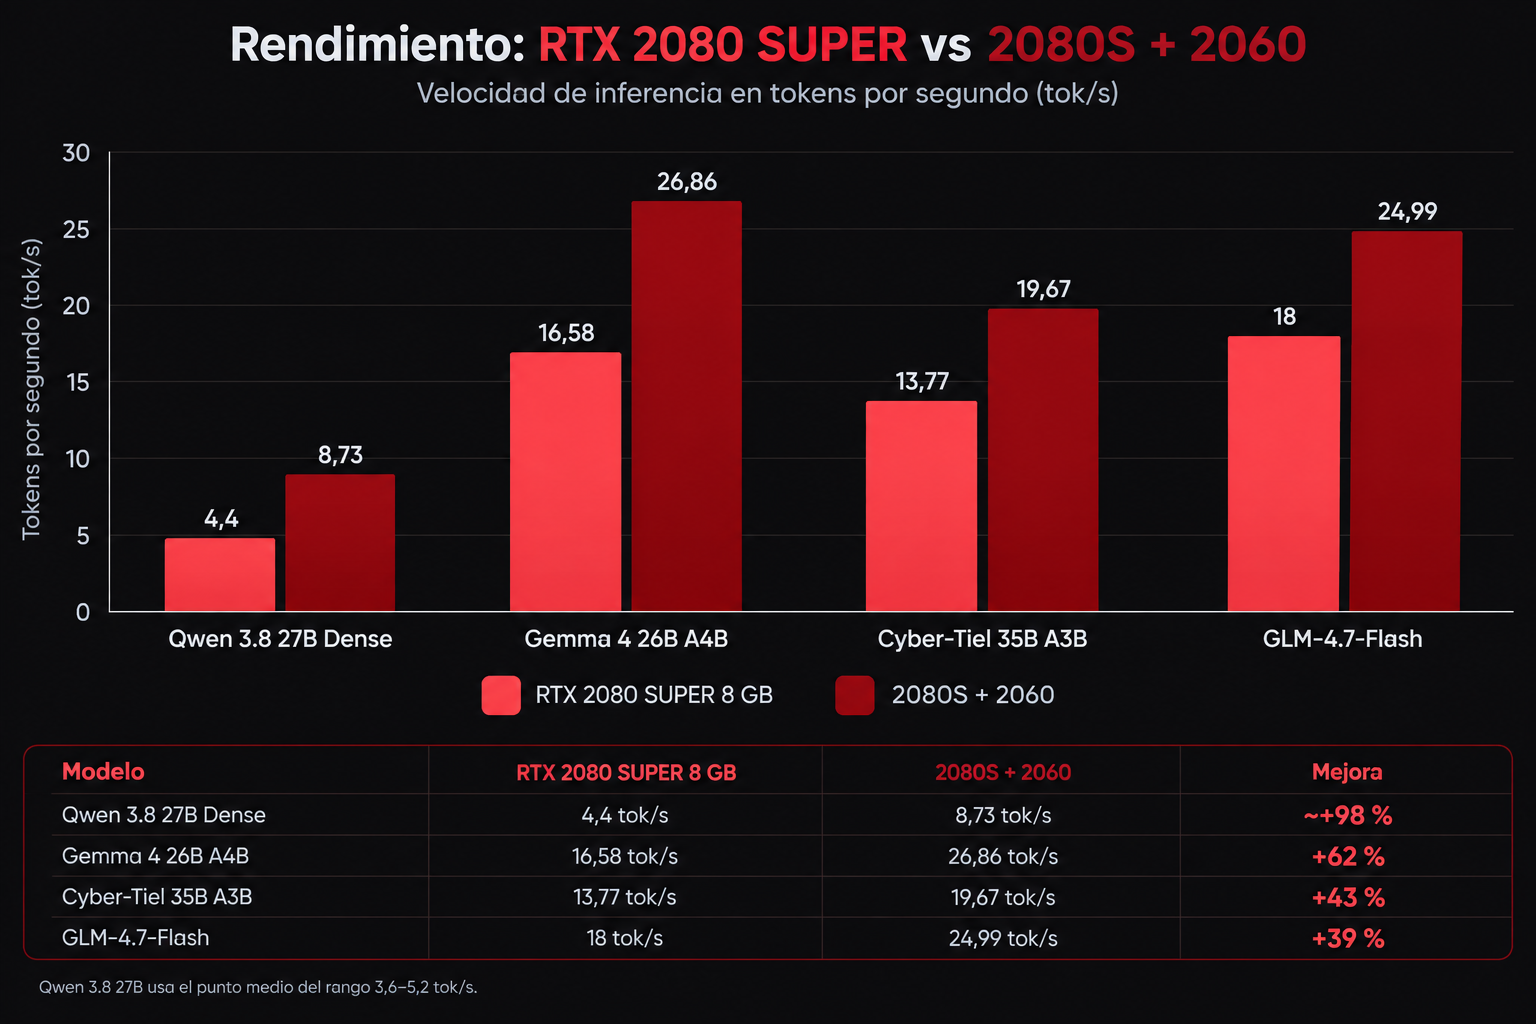
Aquí aparece uno de los resultados más interesantes de todo el experimento. La segunda GPU sí aporta una mejora notable. Pero la mejora depende mucho de la arquitectura del modelo.
11. ¿Cuánto se nota realmente una RTX 2060 de 6 GB?
En términos de tokens por segundo, la respuesta es: se nota bastante.
No estamos hablando de un 5 % o un 10 %. Los modelos MoE utilizados en esta prueba mejoraron entre un 39 % y un 62 %. El modelo Dense de 27B llegó aproximadamente a duplicar su velocidad: 3,6–5,2 tok/s → 8,73 tok/s. Eso supone una mejora de hasta aproximadamente 98 %.
Pero hay que entender por qué. Con una sola RTX 2080 SUPER de 8 GB, un modelo Dense grande depende mucho más del offload hacia RAM. Cuando se añaden otros 6 GB de VRAM, una parte mucho mayor del modelo puede permanecer en memoria de GPU. El cuello de botella cambia.
La RAM deja de tener que participar tanto en el movimiento de los datos necesarios para generar cada token. Por eso el modelo Dense es precisamente el que presenta el mayor salto relativo.
12. ¿Y qué ocurre con los modelos MoE?
Aquí la situación cambia. Los MoE ya se comportan relativamente bien con poca VRAM porque el número de parámetros activos por token es mucho menor que el número total de parámetros. Por eso el salto al añadir la RTX 2060 es más moderado:
- Gemma 4: +62 %
- Cyber-Tiel: +43 %
- GLM: +39 %
Pero «más moderado» no significa pequeño. Un aumento del 39 % significa pasar de aproximadamente 17–19 tok/s → 24,99 tok/s. En una sesión larga de generación, esa diferencia se acumula. Y en un agente que realiza decenas de iteraciones puede tener un impacto importante.
13. ¿14 GB de VRAM significan realmente 14 GB?
No exactamente. Esto es importante para cualquiera que esté pensando en montar una configuración similar.
Dos tarjetas con 8 GB y 6 GB no se convierten en una única GPU virtual de 14 GB con las mismas características que una tarjeta de 14 GB. La memoria sigue estando físicamente distribuida entre dos dispositivos. El software tiene que repartir el trabajo.
En este caso, LM Studio permite utilizar las dos GPUs, pero el reparto no equivale a disponer de una única memoria VRAM unificada.
Por tanto, la forma correcta de describir esta configuración es: RTX 2080 SUPER 8 GB + RTX 2060 6 GB con ejecución distribuida, no «una GPU de 14 GB».
14. El tamaño de la segunda GPU importa menos de lo que parece
Hay otra conclusión interesante. La segunda tarjeta no tiene que ser igual de potente que la principal para resultar útil.
La RTX 2060 tiene 6 GB de VRAM, menos potencia que la RTX 2080 SUPER (mismo proceso Turing, pero un chip más pequeño y con menos núcleos) y un precio de segunda mano mucho más bajo. En esta configuración, LM Studio distribuyó la carga del modelo entre ambas GPUs: la segunda tarjeta no actúa como una extensión transparente de la VRAM de la primera, cada GPU conserva su propia memoria y es el backend el que decide cómo repartir el modelo y el trabajo entre dispositivos. Aun así, ese reparto reduce la dependencia de la RAM del sistema.
El resultado medido demuestra que una GPU secundaria relativamente barata puede tener un efecto importante en inferencia local. Eso no significa que cualquier combinación de GPUs vaya a producir los mismos números. Dependerá de: arquitectura, tamaño del modelo, cuantización, reparto entre dispositivos, ancho de banda, CPU, RAM, contexto y software utilizado.
Pero el principio queda demostrado en este equipo.
15. ¿Compensa comprar una segunda GPU barata?
Con los datos de esta prueba, hay una respuesta bastante clara: si ya tienes una GPU compatible y puedes conseguir una segunda tarjeta barata, la mejora puede ser perfectamente apreciable.
La RTX 2060 utilizada aquí cuesta en el mercado de segunda mano poco más de 100 €. Por ese desembolso, las mediciones obtenidas fueron:
- hasta +98 % en un Dense 27B;
- +62 % en Gemma 4;
- +43 % en Cyber-Tiel;
- +39 % en GLM.
No es una mejora teórica. Es una diferencia medida en tokens por segundo.
Ahora bien, hay una diferencia importante entre rentabilidad económica y compatibilidad técnica. Una segunda GPU implica más consumo, más calor, más espacio ocupado, más complejidad, necesidad de que la placa base y la fuente puedan soportarla, y un software capaz de distribuir correctamente el modelo.
Por tanto, no tiene sentido comprar una segunda GPU únicamente porque tenga 6 GB adicionales. Tiene sentido cuando esos 6 GB atacan un cuello de botella real. En este experimento, ese cuello de botella era especialmente evidente en los modelos grandes y densos.
16. Inferencia bruta frente a programación autónoma
Aquí hay que evitar una conclusión equivocada. Los números de la segunda GPU son tokens por segundo de inferencia, no una promesa de que una tarea de programación tardará exactamente un 39 %, 62 % o 98 % menos.
El agente tiene un coste adicional. Cada iteración implica: recibir el contexto, procesarlo, generar una respuesta, ejecutar herramientas, leer los resultados, incorporar ese resultado al contexto y volver a inferir. Y el contexto crece.
En el caso de GLM, por ejemplo, la suma de los tokens enviados en los prompts de las 97 iteraciones alcanzó aproximadamente 1,77 millones de tokens. Esto no significa que el modelo tuviera 1,77 millones de tokens dentro de una única ventana de contexto: son tokens acumulados a través de las sucesivas llamadas, no un contexto simultáneo. Por eso los 17–27 tok/s de las mediciones directas no se traducen directamente en los 10–17 tok/s observados durante la programación autónoma. El agente está haciendo mucho más que generar texto.
Esta diferencia es fundamental cuando se comparan GPUs para agentes locales.
El benchmark de inferencia dice cuánto puede acelerar el motor. El benchmark de agente dice cuánto puede acelerar una tarea real.
17. Dense frente a MoE: aquí está la diferencia
Una de las conclusiones más claras de la prueba es que no conviene mirar únicamente el número de parámetros. Un modelo Dense de 27B puede resultar mucho más exigente que un MoE de 35B. ¿Por qué?
35B MoE
→ ~3B activos por token

27B Dense
→ gran parte de sus 27B participa en cada token
Esto no significa que los parámetros inactivos sean irrelevantes para la memoria. Siguen formando parte del modelo. Pero sí cambia enormemente el coste computacional de generar cada token. Las mediciones de inferencia lo reflejan:
| Tipo de modelo | Rendimiento aproximado |
|---|---|
| Dense 27B con 8 GB | ~2,3–5,5 tok/s |
| MoE 26–35B con 8 GB | ~13–19 tok/s |
El rango de «Dense 27B con 8 GB» agrega el conjunto más amplio de candidatos Dense de ~27B probados en este equipo, no solo la medición específica de Qwen 3.8 27B Dense de la sección 10 (3,6–5,2 tok/s), que corresponde en concreto a las pruebas de la comparación con/sin segunda GPU.
La arquitectura puede importar tanto o más que el tamaño nominal del modelo.
18. ¿Y qué pasa con los modelos Dense de 27B?
En esta prueba, los modelos Dense de aproximadamente 27B no consiguieron completar la tarea de programación autónoma. Esto merece una explicación porque sería fácil atribuirlo exclusivamente a los 8 GB de VRAM.
Los registros muestran que el problema estuvo también relacionado con el comportamiento de los propios modelos. Uno de los candidatos tendía a mantener cadenas de razonamiento excesivamente largas y agotaba repetidamente el presupuesto de salida. Otro mostraba un comportamiento de generación poco adecuado para el límite temporal del agente.
Por tanto, el resultado correcto no es: «27B Dense no funciona con 8 GB.»
Los modelos Dense de 27B probados en este experimento no consiguieron completar la tarea bajo estas condiciones.
Es una diferencia importante. El hardware es solo una parte del sistema.
Un caso concreto: tres variantes de un mismo modelo, tres intentos de arreglo
Uno de los candidatos Dense de 27B se probó en tres cuantizaciones distintas a lo largo de esta investigación, cada una tras diagnosticar por qué había fallado la anterior. Vale la pena detallarlo porque ilustra bien el problema de fondo.
La primera cuantización (muy agresiva, ~3,7 bits por parámetro) se quedaba sin escribir ningún archivo, agotando su presupuesto de razonamiento sin llegar nunca a invocar una herramienta. La segunda, más fiel al modelo original (Q4_K_M, 17,7 GB), sí razonaba con normalidad en pruebas sueltas, pero no cabía en la VRAM combinada de este equipo y su velocidad se resentía. La tercera (Q3_K_M, 14,3 GB) sí cabía y llegaba a acercarse a los 10 tok/s — pero, frente al prompt real de esta tarea, cayó en el mismo problema que la primera: con el ajuste de razonamiento más bajo disponible («low»), gastó 15.972 de 16.000 tokens de margen pensando, sin escribir ni un carácter de código; con el razonamiento completamente desactivado («none») gastó 7.942 de 8.000 en lo mismo.
Lo más revelador es el contraste: ese mismo modelo, ante un prompt de prueba sencillo (una clase con un botón que incrementa un contador), respondía en poco más de tres minutos usando apenas 80 tokens de razonamiento. Frente a la tarea real de este artículo — con animación, geometría y una suite de tests que cumplir — el mismo ajuste que funcionaba perfectamente en la prueba sencilla no bastaba para que el modelo supiera cuándo dejar de pensar.
También se probó acelerarlo con un modelo draft (decodificación especulativa) de la misma familia, buscando superar su techo de velocidad — la carga falló directamente por falta de VRAM para el caché del draft, sin margen siquiera para probarlo.
Ningún ajuste de razonamiento probado —bajo, ninguno, o el que trae por defecto— evitó el problema en la tarea real. Por eso estos candidatos Dense quedaron fuera de la comparación final: no por el tamaño del modelo ni por la VRAM disponible, sino por no saber cuándo parar de razonar frente a una tarea suficientemente compleja.
19. El coste oculto del contexto
Cuando se habla de ejecutar modelos locales, normalmente se presta mucha atención a parámetros, VRAM y tokens por segundo. En agentes autónomos hay otro factor que puede ser todavía más importante: el contexto.
Cada nueva iteración puede añadir comandos ejecutados, resultados, mensajes, contenido de archivos, errores, correcciones e instrucciones anteriores. Por tanto, una tarea que empieza con un prompt pequeño puede acabar obligando al modelo a procesar una cantidad enorme de contexto.
Esto explica por qué un modelo puede tener un rendimiento excelente en una medición de prompt corto y después comportarse de forma mucho más lenta dentro de un agente. La programación autónoma es, en este sentido, una prueba mucho más exigente que una conversación normal.
20. Qué demuestra realmente esta prueba
Después de ejecutar las pruebas, las conclusiones más útiles son bastante concretas.
Una RTX 2080 SUPER de 8 GB puede utilizarse para programación autónoma con modelos grandes
Con cuantización, MoE y offload a RAM es posible trabajar con modelos de 26–35B. No significa que todos los modelos de ese tamaño funcionen igual. La arquitectura importa muchísimo.
Los modelos MoE tienen una ventaja evidente en este escenario
Los tres modelos que completaron la tarea son MoE y utilizan aproximadamente 3–4B de parámetros activos por token.
Una segunda GPU barata puede aportar bastante
Añadir una RTX 2060 de 6 GB produjo mejoras de entre +39 % y +98 % en las pruebas de inferencia realizadas.
El beneficio es especialmente interesante en modelos Dense
El modelo Dense de 27B fue el que más mejoró relativamente, pasando de aproximadamente 3,6–5,2 tok/s a 8,73 tok/s.
La velocidad no es lo mismo que capacidad de terminar
Gemma fue extremadamente rápido en la primera ejecución. GLM, en cambio, produjo un programa funcional pero pasó alrededor de 90 minutos sin cerrar correctamente el proceso. En un agente autónomo, la capacidad de terminar forma parte del rendimiento.
Qué demuestra y qué no demuestra esta prueba
Resumiendo todo lo anterior en un solo sitio, para que quede claro hasta dónde llegan estas conclusiones y dónde hay que dejar de extrapolar:
| Esta prueba sí demuestra | Esta prueba no demuestra |
|---|---|
| Que estos modelos pudieron ejecutarse en este equipo | Que cualquier modelo de 35B funcione con 8 GB |
| Que los tres modelos produjeron una aplicación funcional | Que los tres agentes completaran correctamente el ciclo |
| Que la segunda GPU aumentó el rendimiento medido | Que cualquier pareja de GPUs escale igual |
| Que los MoE probados tuvieron un comportamiento favorable | Que MoE sea siempre superior a Dense |
| Que una 2060 puede aportar rendimiento adicional | Que una segunda GPU sea siempre económicamente mejor |
| Que tok/s y finalización de tareas son métricas diferentes | Que +98 % de tok/s implique +98 % de productividad |
| Que el offload permite trabajar con modelos mayores que la VRAM | Que el modelo entero quepa en 8 GB |
21. Limitaciones de la prueba
Estos resultados deben interpretarse dentro de sus condiciones. No es un benchmark universal de modelos de programación. Las principales limitaciones son:
- Una única tarea principal. La ruleta no representa proyectos grandes, backend, bases de datos o aplicaciones complejas.
- Una única ejecución por configuración de GPU. La comparación solo-2080S / 2080S+2060 de la sección 6 tiene un único caso por lado — sirve para ver el efecto sobre la tarea completa, no para hablar de consistencia estadística.
- Dos comparaciones de GPU distintas, con objetivos distintos. Las secciones 9 a 15 miden inferencia bruta (tokens por segundo) con varias mediciones por modelo. La sección 6 mide el pipeline de agente completo, pero con una sola ejecución por configuración — úsala para ver el efecto cualitativo, no como una medición de velocidad de inferencia aislada.
- Los resultados dependen del conjunto completo. Modelo, cuantización, LM Studio, OpenCode, Agente Jiménez, CPU, RAM y configuración de GPU forman parte del resultado.
- No todos los modelos Dense completaron la tarea. Por tanto, no existe aquí una comparación equilibrada entre Dense y MoE en cuanto a tiempo de finalización de una misma tarea.
- El reparto multi-GPU depende del software. Tener físicamente 14 GB no equivale a disponer de una única GPU con 14 GB de memoria unificada.
Estas limitaciones no invalidan el experimento. Delimitan qué preguntas puede responder.
22. Configuración para reproducir la prueba
| Parámetro | Valor |
|---|---|
| CPU | Ryzen 7 5800X |
| RAM | 32 GiB |
| GPU | RTX 2080 SUPER 8 GB |
| Segunda GPU | RTX 2060 6 GB |
| Sistema | Garuda Linux + KDE Plasma |
| Motor | LM Studio + CUDA |
| Reparto de GPU | --gpu 0.5 (ver nota) |
| Agente | Agente Jiménez |
| Coder | OpenCode |
| max_output_tokens | 8192 por llamada |
| pipeline_task_timeout_seconds | 7200 por caso |
| Tarea | ruleta.py en Python |
| Prompt | idéntico para los modelos |
La prueba se realizó utilizando el motor CUDA. En este equipo, el backend Vulkan no se utilizó debido a problemas de estabilidad.
Nota sobre el reparto entre GPUs: LM Studio no expone ningún control fino de reparto multi-GPU (sin tensor-split, sin main-gpu, sin selector de dispositivo en la interfaz ni en la configuración persistida por modelo). El único parámetro disponible es un ratio general —--gpu max o valores intermedios como --gpu 0.5— y es el propio motor quien decide internamente cuánto va a cada tarjeta. En esta prueba se usó --gpu 0.5 para los tres modelos, confirmado como la configuración que cargaba de forma fiable sin error de asignación de VRAM; no fue posible verificar con nvidia-smi el reparto exacto en cada una de las seis ejecuciones. Esto limita cuánto se puede reproducir exactamente el experimento con otro software que sí exponga ese control.
23. Entonces, ¿merece la pena una segunda GPU?
Si la pregunta es exclusivamente si 6 GB adicionales de una RTX 2060 barata pueden producir una diferencia real, los números de este experimento dicen que sí. El incremento medido no fue marginal: +39 %, +43 %, +62 % y hasta +98 %.
Pero la segunda GPU no debe entenderse como una sustitución barata de una GPU moderna de gran VRAM. Es otra estrategia.
Si ya se dispone de una RTX 2080 SUPER y el objetivo es experimentar con IA local, una RTX 2060 de segunda mano puede tener sentido porque permite aumentar la capacidad de procesamiento disponible sin tener que sustituir la tarjeta principal.
En cambio, si se parte desde cero, hay que comparar el coste total de: una GPU grande, dos GPUs usadas, consumo eléctrico, fuente de alimentación, refrigeración y compatibilidad del software.
La prueba demuestra que la configuración dual funciona y que puede acelerar la inferencia de forma importante. No demuestra que sea siempre la opción económicamente óptima para cualquier usuario.
24. La conclusión más importante
La parte más interesante de este experimento no es realmente la ruleta. Es lo que ocurre cuando se juntan modelos grandes, hardware antiguo y agentes autónomos.
Una RTX 2080 SUPER de 8 GB, una tarjeta que ya no pertenece a la generación actual, puede participar en un sistema capaz de ejecutar modelos locales de 26–35B y completar tareas de programación autónoma.
El secreto no está en una única característica. Está en la combinación: cuantización + MoE + parámetros activos + RAM + software de inferencia + agente + herramientas.
Después, añadir una RTX 2060 de 6 GB por poco más de 100 € no convierte mágicamente el equipo en una máquina de 14 GB de VRAM unificada. Pero las mediciones muestran algo más útil: esos 6 GB adicionales pueden reducir de forma importante el cuello de botella y aumentar la velocidad de inferencia entre un 39 % y un 98 % según el modelo.
Para un modelo Dense grande, la diferencia puede acercarse al doble. Para los MoE, el incremento es menor, pero sigue siendo suficientemente grande como para notarse.
Y esa es probablemente la lección más útil para quien quiera montar un laboratorio de IA local con hardware de segunda mano:
No siempre hace falta comprar una GPU nueva y cara. A veces, entender dónde está el cuello de botella permite sacar mucho más rendimiento del hardware que ya tenemos.
25. Prueba de producción: cuando queremos un resultado acabado
El benchmark terminó aquí. Todo lo medido hasta ahora —tiempos, iteraciones, verificaciones, tok/s— describe qué es capaz de completar un modelo local dentro de un agente autónomo, con un número de intentos limitado y sin ninguna intervención humana durante la tarea.
Ahora utilizamos uno de los modelos del experimento en un flujo de trabajo completamente distinto: colaborativo, con varias rondas de peticiones y correcciones, igual que trabajarías con cualquier herramienta en el día a día — no otra medición del mismo benchmark.
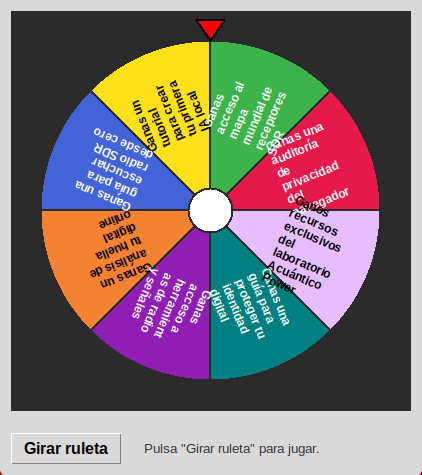
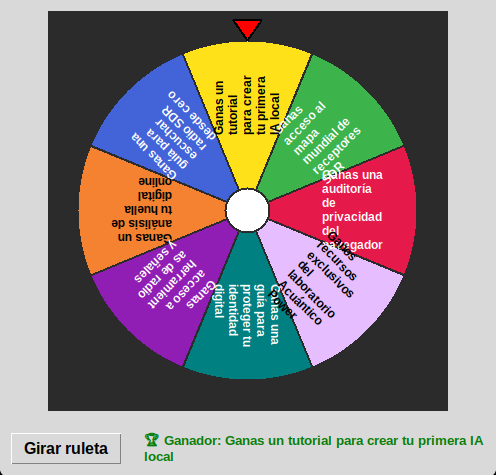
Como cierre, un ejemplo práctico de eso: se le pidió a Gemma 4 26B (el más rápido y equilibrado de los tres modelos de esta comparativa), corriendo solo con la RTX 2080 SUPER de 8 GB, que analizara las seis implementaciones reales de la ruleta generadas durante el benchmark — las de los tres modelos, con y sin la segunda GPU — y se quedara con las mejores ideas de cada una para construir una versión nueva, pensada para la web: HTML, CSS y JavaScript autocontenidos, con un acabado profesional, y con los 8 premios convertidos en enlaces reales a otros artículos de este laboratorio.
Le llevó varias rondas de peticiones concretas — que la paleta de colores encajara con la de esta web, que el texto de los premios no se solapara, que el acabado tuviera más relieve — hasta llegar a una versión que funcionara bien de verdad. Así es, en la práctica, trabajar con un modelo local en un flujo real: no un único intento perfecto, sino ir afinando con instrucciones cada vez más concretas hasta cerrar el resultado.
Pruébala tú mismo — gira la ruleta, y cada premio te lleva a un artículo relacionado de este laboratorio.
Preguntas frecuentes
¿Se puede ejecutar un modelo de 30B con una RTX 2080 SUPER de 8 GB?
Sí, al menos con los modelos MoE probados en este experimento. La combinación de cuantización, parámetros activos y offload a RAM permite ejecutar modelos cuyo tamaño total supera ampliamente los 8 GB de VRAM.
¿Una RTX 2060 de 6 GB ayuda realmente a una RTX 2080 SUPER?
Sí. En las mediciones realizadas, la combinación de ambas GPUs aumentó la velocidad de inferencia entre aproximadamente un 39 % y un 98 %, dependiendo del modelo.
¿Los 8 + 6 GB se convierten en 14 GB de VRAM?
No. Las dos tarjetas mantienen su propia memoria. El software puede repartir el modelo y el trabajo entre ellas, pero no se comportan exactamente como una única GPU con 14 GB de VRAM unificada.
¿Qué modelo fue más rápido en la programación autónoma?
Gemma 4 26B fue el que necesitó menos tiempo en las dos ejecuciones realizadas, aunque mostró una variación importante entre ambas: aproximadamente 4 y 13 minutos.
¿Qué modelo fue más consistente?
Cyber-Tiel 35B produjo resultados verificados en las dos ejecuciones, con aproximadamente 38–42 minutos de tiempo total y alrededor de 22.000 tokens generados en cada una.
¿GLM-4.7-Flash falló?
No exactamente. El programa generado resultó funcional, pero el pipeline no consiguió cerrar automáticamente el proceso de verificación en ninguna de las dos ejecuciones. El problema estuvo en el ciclo autónomo, no simplemente en el código producido.
¿MoE es siempre mejor que Dense?
No. Este experimento no permite establecer una regla universal. Lo que sí muestra es que los modelos MoE probados fueron los que consiguieron completar la tarea bajo estas condiciones.
¿Qué son los parámetros activos?
Son los parámetros que participan en el procesamiento de cada token en una arquitectura MoE. Un modelo puede tener 35B de parámetros totales y activar solo una fracción de ellos para cada token.
¿Puede una IA local programar sin intervención humana?
En esta prueba, los tres modelos que llegaron a producir el resultado final dejaron una aplicación funcional sin intervención humana durante la tarea. En dos casos, además, el propio pipeline confirmó automáticamente el resultado.
¿Por qué el rendimiento del agente es menor que el de una prueba de tokens por segundo?
Porque un agente no se limita a generar tokens. Tiene que procesar el contexto acumulado, ejecutar comandos, leer resultados y volver a razonar. Cuantas más iteraciones realiza, mayor puede ser el coste del contexto.
¿Qué aporta realmente OpenCode frente a un chatbot?
OpenCode permite trabajar sobre archivos reales, ejecutar comandos y observar los resultados dentro del proyecto. El modelo puede utilizar esa información para decidir qué hacer a continuación. El chatbot convencional se limita principalmente a generar una respuesta de texto.