Clonar tu voz en local con 8 GB: lo que medí con Qwen3-TTS en una RTX 2080 SUPER
Hace no tanto, la clonación de voz en local era cosa de laboratorios: para que un ordenador hablara con tu voz necesitabas horas de grabaciones, un estudio y bastante paciencia.
Hoy bastan treinta segundos.
Treinta segundos de audio y su transcripción. Nada más.
Con eso, un modelo de texto a voz aprende tu timbre, tu ritmo y tu forma de acabar las frases, y lee lo que le escribas como si fueras tú.
Los servicios en la nube llevan tiempo vendiendo esto. Subes tu voz, pagas una suscripción y listo. El pequeño detalle es que tu voz, que es casi tan tuya como tu cara, se queda en el servidor de otro.
Así que la pregunta que me interesaba era otra:
¿Puede un PC doméstico con una GPU de 8 GB clonar una voz en local, sin enviar nada a nadie, y sostenerla durante un audio largo sin que se note la máquina?
No me vale con que arranque.
He clonado mi propia voz.
He generado más de cuarenta audios con dos tamaños de modelo.
He medido la VRAM cada 200 milisegundos.
He estropeado a propósito la muestra de referencia de tres maneras distintas.
He transcrito todo lo generado para contar los errores de lectura.
Y he medido, con huellas de voz, cuánto se parece cada audio a mi voz real, segundo a segundo.
Por el camino me encontré dos sorpresas que no esperaba. Una tiene que ver con la velocidad y la otra con la longitud de los audios. Las dos cambian la forma de trabajar con esto.
Resumen de resultados
| Pregunta | Respuesta medida |
|---|---|
| ¿Cabe en 8 GB? | Sí, pero justo: el modelo grande deja 0,7 GB libres; el pequeño, 2,4 GB |
| ¿Cuánto tarda? | Unos 1,35 s por cada segundo de audio: un podcast de 15 minutos son unos 20 minutos de generación |
| ¿El modelo pequeño es más rápido? | No. Tarda lo mismo: el ritmo lo marca un núcleo del procesador al 100 %, mientras la gráfica trabaja al 40 % |
| ¿Se mantiene la voz en un audio largo? | Generado de golpe, no: el parecido cae de 0,949 a 0,884 en menos de un minuto. Troceado en frases, se mantiene |
| ¿Importa la muestra? | Mucho: con una muestra «de radio» el parecido cae a 0,866, y con solo 5 segundos, a 0,893 |
| ¿Lee bien números y siglas? | El modelo grande, casi siempre. El pequeño falla en las tres repeticiones |
Qwen3-TTS en Voicebox 0.5.0 · RTX 2080 SUPER de 8 GB · parecido medido con huellas de voz (1 = idéntica).
Qué es clonar una voz (y qué no es)
Conviene separar dos cosas que se mezclan mucho:
- Texto a voz con voces predefinidas: el modelo trae un catálogo de voces y eliges una. Suena bien, pero no es nadie concreto.
- Clonación de voz: le das una muestra de una persona real y el modelo genera voz nueva con ese timbre.
Y dentro de la clonación hay otra distinción importante.
La clonación «clásica» entrenaba un modelo nuevo para cada voz. Horas de audio, horas de GPU.
La que he usado aquí es clonación sin entrenamiento (zero-shot). El modelo ya se entrenó una vez con muchísimas voces. Cuando le das tu muestra no aprende nada: la usa como referencia en cada generación, igual que un imitador que escucha a alguien unos segundos antes de ponerse a hablar como él.
Por eso es rápido de preparar.
Y por eso también la muestra lo es todo, como veremos.
Anatomía de una clonación de voz
Antes de medir, quería entender qué ocurre dentro. No por curiosidad académica: sin eso, una de las sorpresas de este artículo no tiene explicación.
El modelo que he usado es Qwen3-TTS, de Alibaba. Abriendo sus ficheros de configuración se ve cómo está montado:
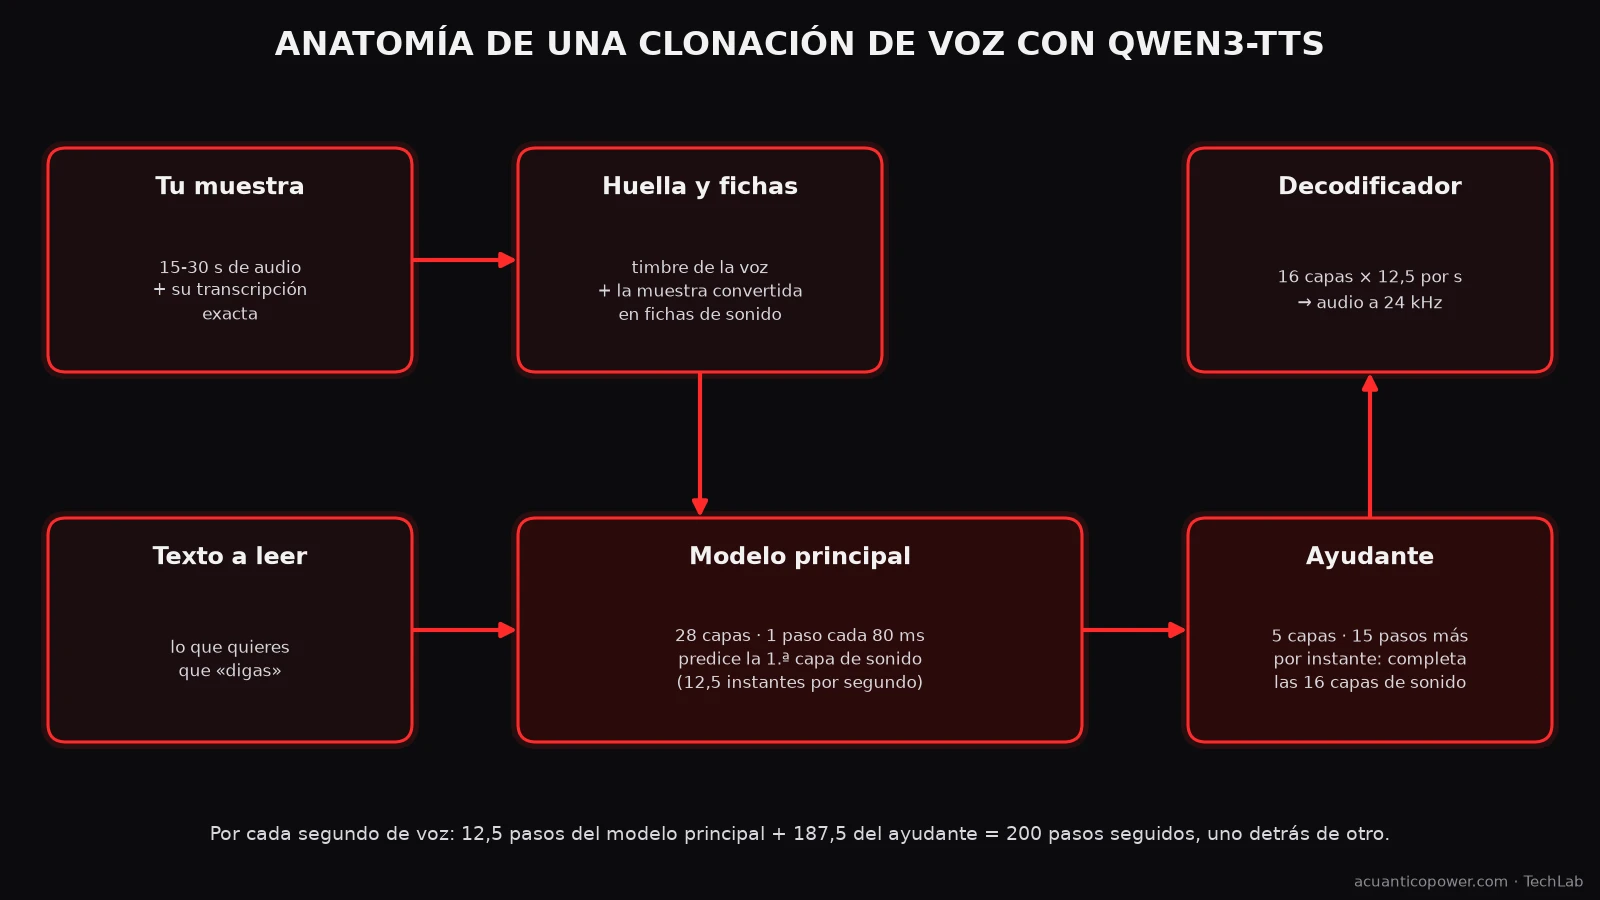
- El sonido se trocea en instantes de 80 milisegundos: 12,5 instantes por cada segundo de voz. Es el «12Hz» que aparece en el nombre del modelo.
- Cada instante se describe con 16 capas de fichas, de lo grueso a lo fino. La primera capa dice más o menos qué suena; las siguientes van añadiendo el detalle que hace que suene a ti y no a un robot.
- Tu muestra entra de dos formas: como una huella del timbre de tu voz y como la propia grabación convertida en fichas, acompañada de su transcripción. Por eso la transcripción tiene que ser exacta: el modelo empareja lo que se oye con lo que pone.
- El modelo principal, de 28 capas, lee el texto y decide la primera capa de fichas de cada instante.
- Un ayudante más pequeño, de 5 capas, completa las otras 15 capas de ese instante, una detrás de otra.
- Un decodificador convierte las fichas en audio a 24 kHz.
La consecuencia práctica está en la última línea de la imagen: por cada segundo de voz, el sistema da unos 200 pasos seguidos, cada uno esperando al anterior. Guárdate este dato. Volverá cuando hablemos de velocidad.
El laboratorio
El PC es el mismo de mis pruebas de diarización con WhisperX y de TRELLIS 2 en 8 GB:
| Componente | Modelo |
|---|---|
| GPU | NVIDIA RTX 2080 SUPER, 8 GB de VRAM (arquitectura Turing, 2019) |
| CPU | AMD Ryzen 7 5800X |
| RAM | 32 GiB |
| Sistema | Garuda Linux |
Para la voz he usado Voicebox (versión 0.5.0), un estudio de voz de código abierto que funciona entero en local. Se presenta como alternativa libre a ElevenLabs, trae siete motores de texto a voz y tiene una API que permite automatizarlo todo. Lo instalé con Pinokio, igual que explico en la guía de instalación de Flux con Pinokio: un clic para instalar y otro para arrancar.
De sus siete motores me quedé con Qwen3-TTS, en sus dos tamaños: 1.7B, el de máxima calidad, y 0.6B, el que Voicebox presenta como rápido.
Metodología
La voz clonada es la mía, a partir de una muestra de 30 segundos grabada con buen micrófono y con su transcripción revisada palabra por palabra.
Todo lo lancé por la API de Voicebox, con un script que repetía las pruebas sin intervención:
- Rendimiento: cuatro textos (corto, medio, largo y uno «difícil» lleno de números y siglas), tres repeticiones de cada uno y con cada tamaño de modelo. Además, la primera generación tras cargar el modelo, para medir el arranque en frío.
- VRAM: muestreada con
nvidia-smicada 200 ms durante cada generación. - Audio largo: un guion de algo más de un minuto, generado de dos formas: de una sola vez y troceado en frases completas.
- Calidad de la muestra: el mismo texto clonado desde mi muestra buena y desde tres versiones estropeadas a propósito con
ffmpeg: con ruido de fondo añadido, filtrada como una radio (solo de 300 a 3.400 Hz) y recortada a 5 segundos. - Errores de lectura: cada audio transcrito con Whisper (large-v3-turbo) y comparado palabra por palabra con el texto pedido.
- Parecido con mi voz: la huella de voz de cada audio comparada con la de mi muestra original usando Resemblyzer, el mismo sistema de huellas que usa Diariza para separar hablantes. El resultado va de 0 a 1: cuanto más cerca de 1, más se parece.
La muestra lo es todo
Si de este artículo te quedas con una sola idea, que sea esta:
El modelo no clona tu voz. Clona tu muestra. Con todo lo que lleve dentro.
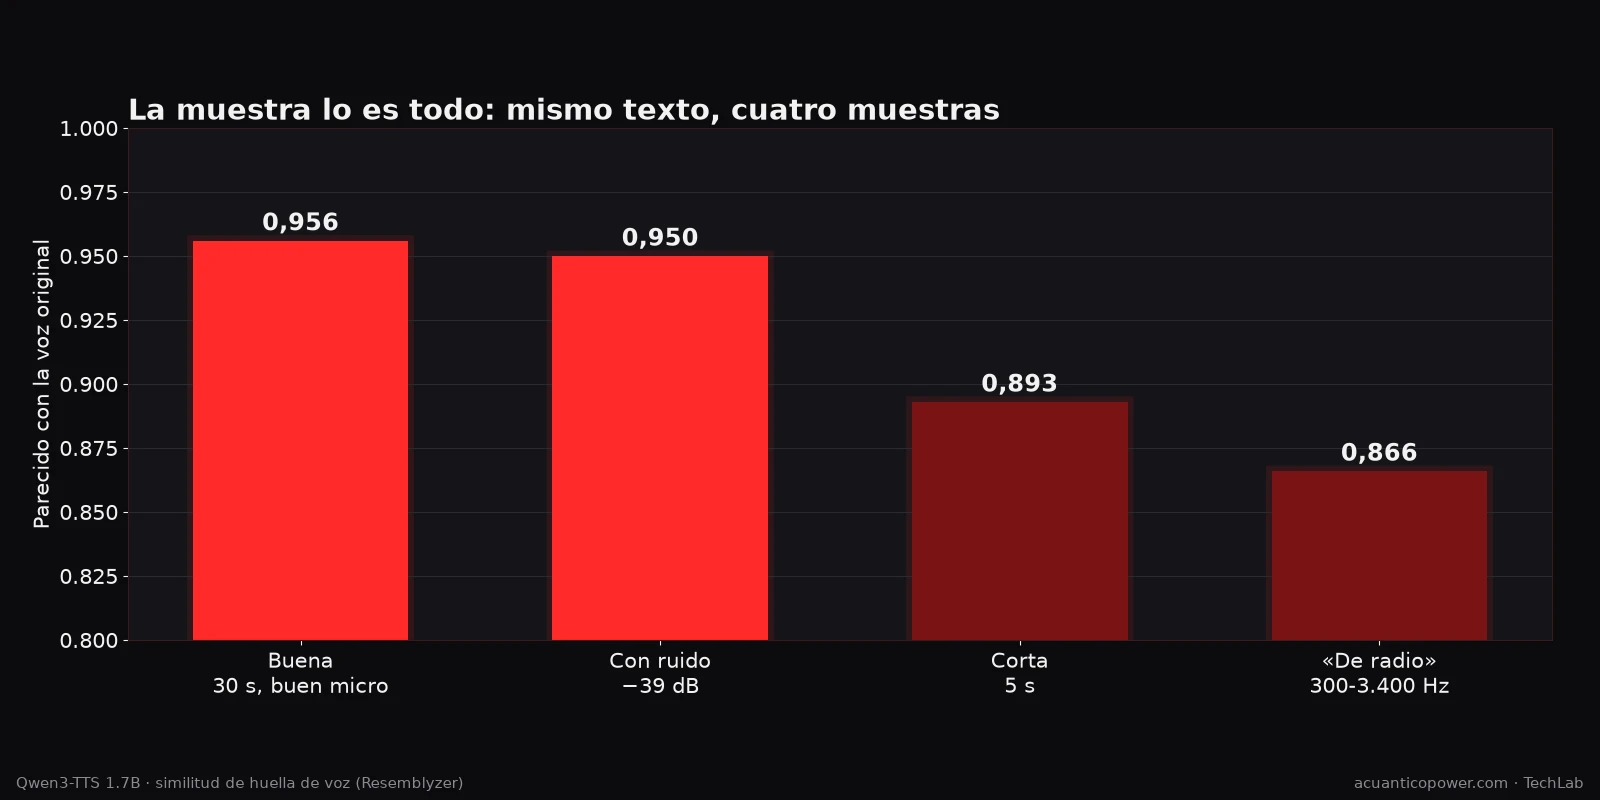
Para comprobarlo, cloné el mismo texto desde cuatro muestras: la buena y las tres estropeadas.
| Muestra | Duración | Problema | Parecido con mi voz |
|---|---|---|---|
| Buena (buen micrófono) | 30 s | ninguno | 0,956 |
| Con ruido de fondo (−39 dB) | 30 s | ruido audible | 0,950 |
| Corta | 5 s | demasiado corta | 0,893 |
| «De radio» (300-3.400 Hz) | 30 s | sin agudos | 0,866 |
La muestra de radio es la que más daño hace. Le faltan los agudos, y en los agudos está buena parte de lo que hace reconocible una voz. No hay modelo que se invente frecuencias que no le has dado.
La corta también hunde el parecido: con cinco segundos el modelo no tiene suficiente material para fijar el timbre.
La de ruido es la más engañosa. La huella de voz apenas cambia, porque el timbre sigue ahí. Pero el ruido no desaparece: viaja con la voz al audio clonado. Esto no lo mide una huella. Se oye:
Con todo esto, estas son las reglas que sigo para grabar una muestra:
- Entre 15 y 30 segundos. Por debajo de 8, el parecido cae. Por encima de 30 o 40 no mejora, y cada generación tarda más, porque el modelo procesa la muestra entera cada vez.
- Ruido de fondo por debajo de −50 dB. Si se oye el ventilador, el clon lo va a «hablar».
- Agudos completos. Nada de grabaciones de radio, teléfono o notas de voz muy comprimidas.
- Transcripción exacta, palabra por palabra. Whisper ayuda a hacerla, pero revísala siempre: Whisper «corrige» muletillas, repeticiones y titubeos, y a ti te interesa justo lo contrario, que el texto coincida con lo que realmente suena.
¿Cabe en 8 GB?
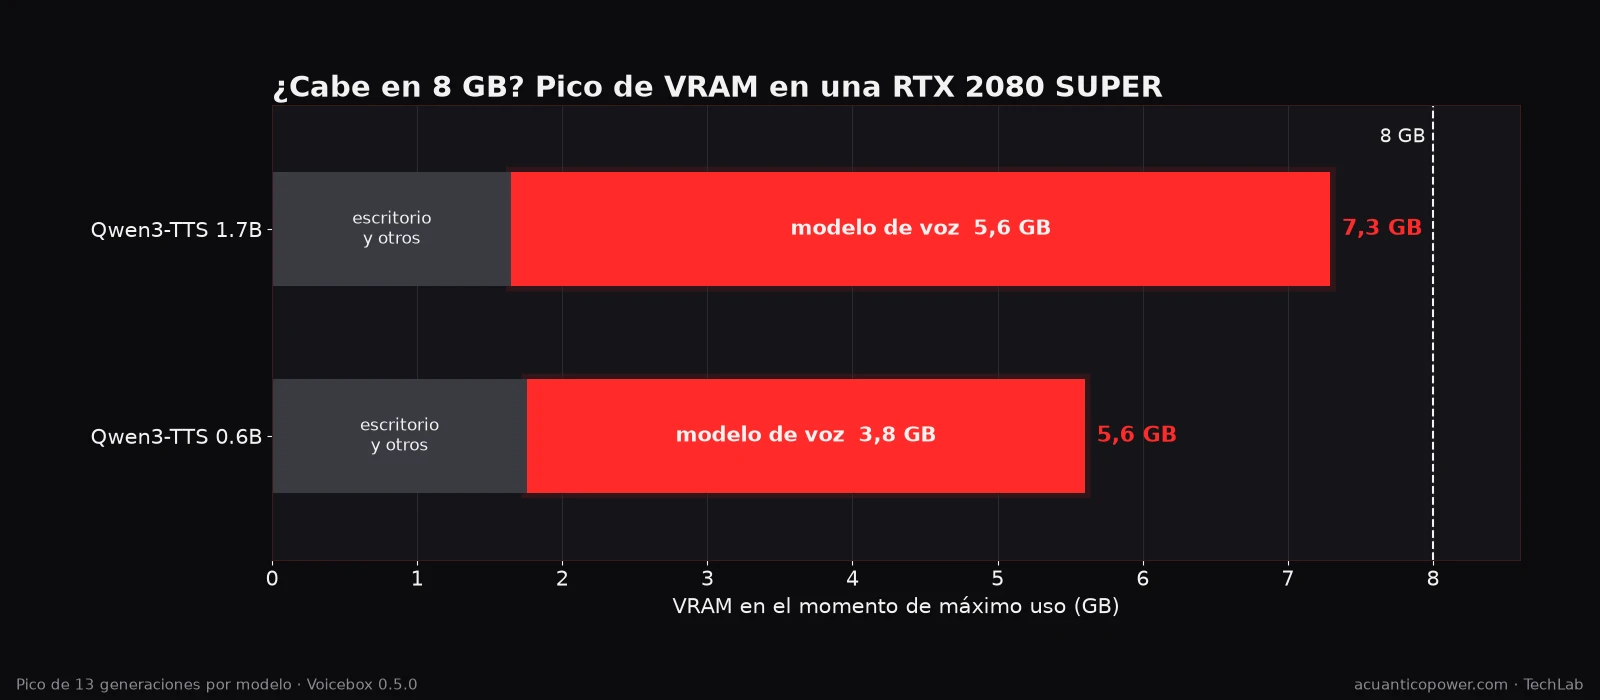
Sí, pero sin margen con el modelo grande.
| Modelo | VRAM ocupada antes de empezar | Pico de VRAM | Del modelo de voz | Libre en el peor momento |
|---|---|---|---|---|
| Qwen3-TTS 1.7B | 1,7 GB | 7,3 GB | 5,6 GB | 0,7 GB |
| Qwen3-TTS 0.6B | 1,8 GB | 5,6 GB | 3,8 GB | 2,4 GB |
Esa parte gris no es de Voicebox: es lo que ya ocupan el escritorio y el resto de programas en la tarjeta. Si tu GPU no mueve el escritorio, tendrás algo más de aire.
La consecuencia práctica es clara: con el modelo grande, en una tarjeta de 8 GB no cabe nada más. Si tienes un modelo cargado en LM Studio o una sesión de ComfyUI abierta, descárgalos antes de generar voz.
Me pasó durante las pruebas. Voicebox usa Whisper para transcribir las muestras, y Whisper y el modelo de voz grande no caben a la vez en 8 GB. La primera vez que coincidieron cargados, la tarjeta se quedó sin memoria y la generación falló. Hay que usarlos por turnos.
¿Cuánto tarda? Primera sorpresa
La medida que importa aquí es el factor de tiempo real (RTF): segundos de cálculo por cada segundo de audio generado. Con un RTF de 1, tarda lo mismo que dura el audio; por encima de 1, va más lento que el tiempo real.
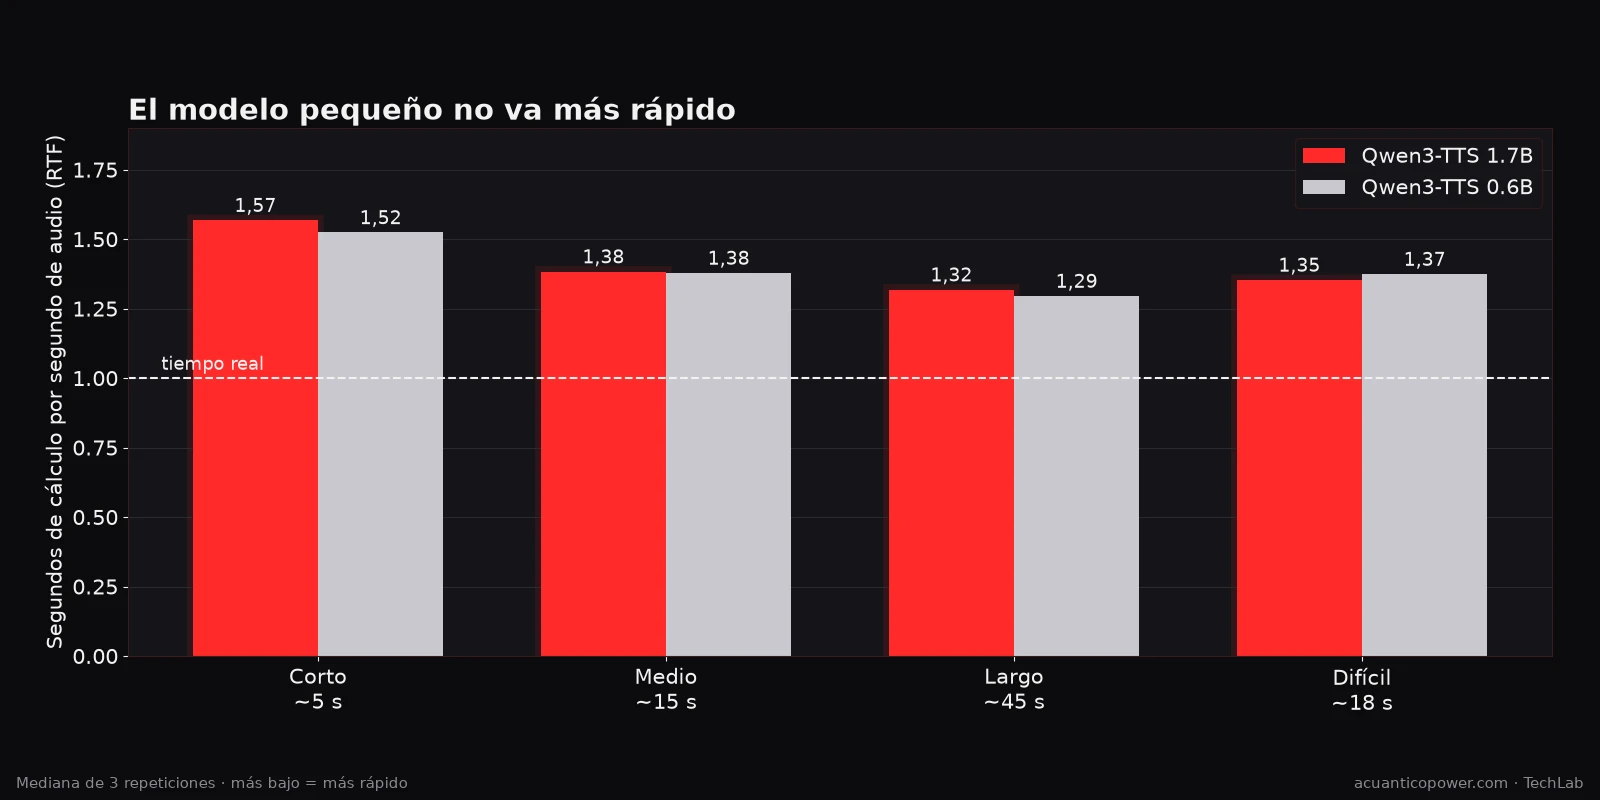
| Texto | Audio | 1.7B: tiempo | 1.7B: RTF | 0.6B: tiempo | 0.6B: RTF |
|---|---|---|---|---|---|
| Corto | ~5 s | 8,0 s | 1,57 | 8,0 s | 1,52 |
| Medio | ~15 s | 20,0 s | 1,38 | 22,0 s | 1,38 |
| Largo | ~45 s | 57,3 s | 1,32 | 63,1 s | 1,30 |
| Difícil (números y siglas) | ~18 s | 24,0 s | 1,35 | 26,0 s | 1,37 |
Medianas de tres repeticiones de cada texto.
Traducido a algo útil: un podcast de 15 minutos tarda unos 20 minutos en generarse. La primera generación tras cargar el modelo tarda un poco más (18 s con el grande y 14 s con el pequeño para una frase de 5 segundos); a partir de ahí, el modelo se queda cargado y va a su ritmo.
Pero lo interesante de esta tabla no es el tiempo. Es que las dos columnas son prácticamente iguales.
El modelo pequeño tiene la tercera parte de parámetros. Ocupa la mitad en disco (1,8 GB frente a 3,6 GB). Voicebox lo presenta como la opción rápida.
Y tarda lo mismo.
Por qué el modelo pequeño no corre más
La respuesta está en la anatomía de antes. Comparando la configuración de los dos modelos:
| Qwen3-TTS 1.7B | Qwen3-TTS 0.6B | |
|---|---|---|
| Capas del modelo principal | 28 | 28 |
| Anchura del modelo principal | 2.048 | 1.024 |
| Capas del ayudante | 5 | 5 |
| Anchura del ayudante | 1.024 | 1.024 |
| Capas de fichas por instante | 16 | 16 |
| Pasos seguidos por segundo de voz | ~200 | ~200 |
El modelo pequeño no es más corto. Es más estrecho.
Tiene exactamente las mismas capas y el mismo ayudante, y tiene que dar exactamente los mismos 200 pasos seguidos por cada segundo de voz. Lo que se ahorra es trabajo dentro de cada paso.
Mi sospecha era que, a esta escala, cada paso es tan pequeño que la gráfica lo despacha enseguida y se queda esperando al siguiente. Así que lo medí: generé el texto largo con cada modelo mientras registraba, cada cuarto de segundo, cuánto trabajaba la gráfica y cuánto procesador usaba Voicebox.
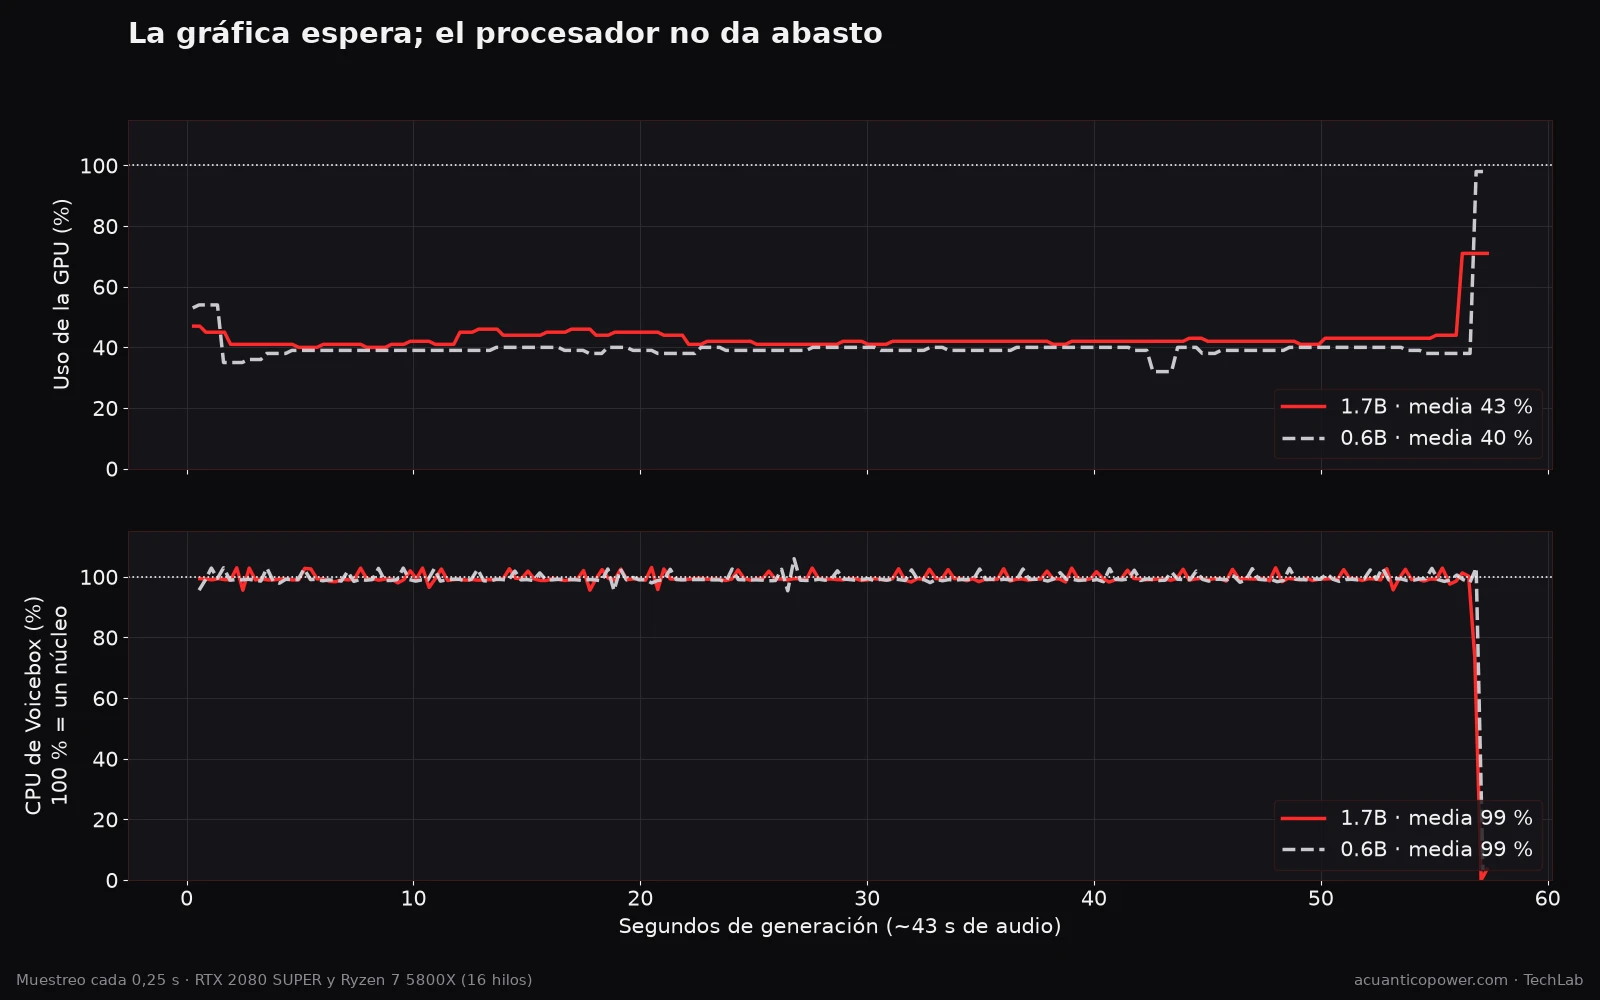
| Qwen3-TTS 1.7B | Qwen3-TTS 0.6B | |
|---|---|---|
| Tiempo de generación | 57,09 s | 57,07 s |
| Uso medio de la GPU | 43 % | 40 % |
| Tiempo con la GPU por encima del 80 % | 0 % | 1 % |
| Consumo medio de la GPU | 100 W | 77 W |
| CPU del proceso de Voicebox | 99 % (un núcleo) | 99 % (un núcleo) |
El resultado no deja lugar a dudas. Los dos modelos tardaron lo mismo, con dos centésimas de diferencia. La gráfica pasó casi todo el tiempo por debajo del 50 %, y una RTX 2080 SUPER que puede consumir 250 W se quedó en 100 W con el modelo grande y en 77 W con el pequeño.
Mientras tanto, el proceso de Voicebox tuvo un núcleo del procesador clavado al 100 % de principio a fin.
El cuello de botella no es la gráfica. Es un solo núcleo del procesador, que tiene que preparar y encargar a la GPU cada uno de esos 200 pasos por segundo, uno detrás de otro. La gráfica resuelve cada encargo en un suspiro y se queda esperando el siguiente. Da igual que el modelo sea ancho o estrecho: el núcleo tarda lo mismo en preparar cada paso.
El final de la gráfica lo confirma por contraste. En los últimos segundos, la CPU cae y la GPU se dispara: es el decodificador, que convierte de golpe todas las fichas en audio. Es el único momento en que la tarjeta trabaja de verdad.
Hay un detalle más sobre mi tarjeta en concreto: Voicebox carga el modelo en bfloat16, un formato numérico que las gráficas Turing como la 2080 SUPER no aceleran de forma nativa. En otro escenario eso pesaría. Aquí no: con la GPU esperando la mitad del tiempo, el formato del cálculo no es lo que frena.
La conclusión práctica es sencilla: en esta tarjeta, el modelo pequeño solo ahorra memoria. Velocidad, ninguna.
La voz que se va alejando: segunda sorpresa
Generar una frase suelta que suene bien es fácil.
Generar quince minutos seguidos que suenen bien es otra historia.
Para comprobarlo generé el mismo guion de algo más de un minuto de dos formas:
- Todo de una vez, en una sola generación.
- Troceado en frases completas, con el script que uso para mis audios largos: fragmentos de unos 350 caracteres que nunca cortan una frase, pausas según la puntuación y el volumen ajustado una sola vez al final.
Después medí el parecido con mi voz en tramos de 10 segundos.
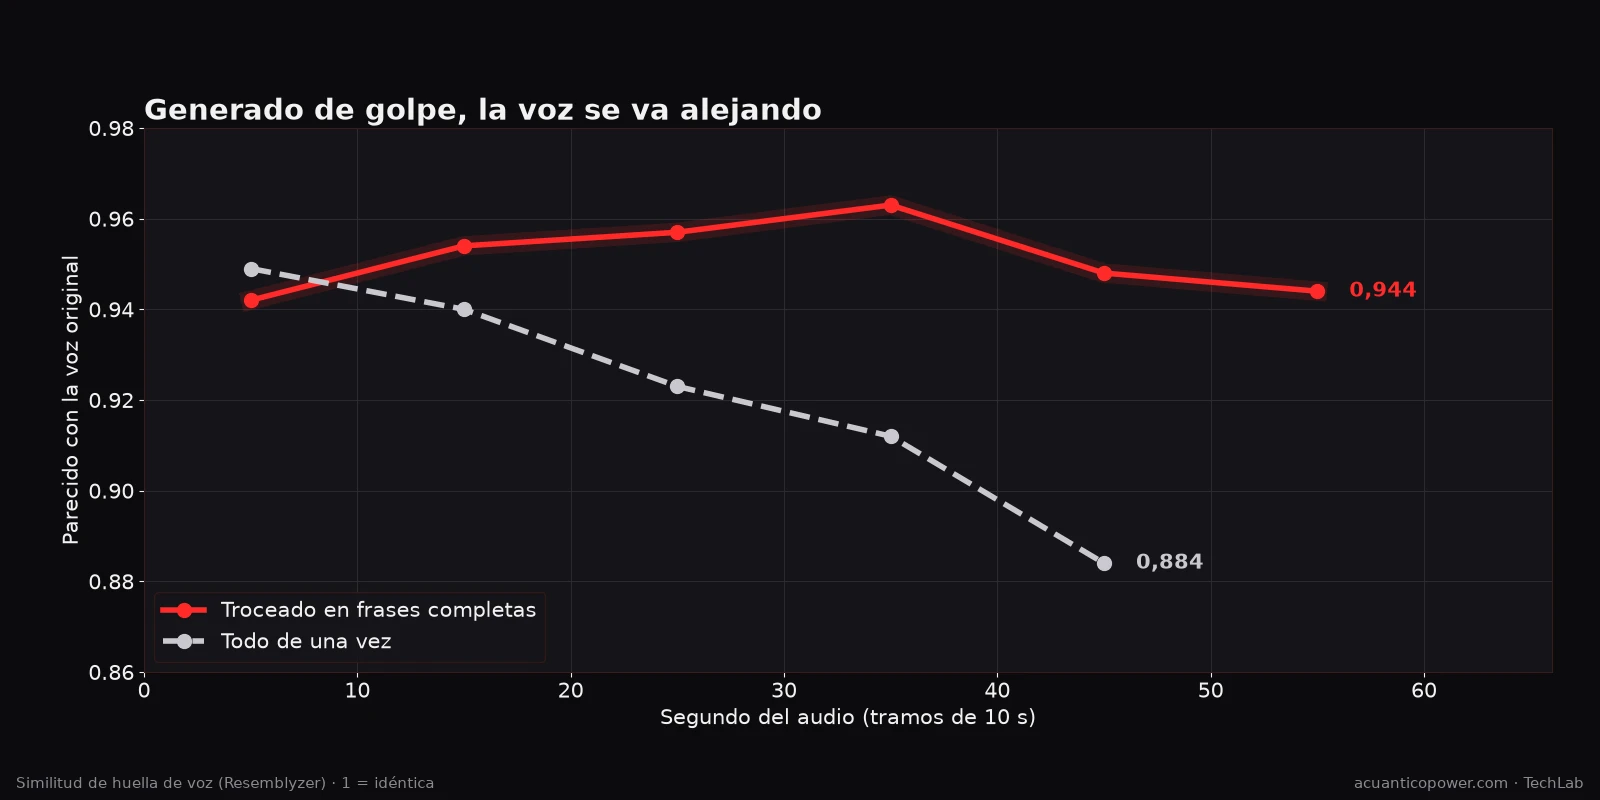
| Tramo | Troceado | Todo de una vez |
|---|---|---|
| 0-10 s | 0,942 | 0,949 |
| 10-20 s | 0,954 | 0,940 |
| 20-30 s | 0,957 | 0,923 |
| 30-40 s | 0,963 | 0,912 |
| 40-50 s | 0,948 | 0,884 |
| 50-60 s | 0,944 | — |
Generado de golpe, la voz empieza siendo la mía y se va alejando segundo a segundo: de 0,949 a 0,884 en menos de un minuto. Troceado, se mantiene entre 0,94 y 0,96 de principio a fin.
Tiene sentido si recuerdas cómo funciona. El modelo genera cada instante mirando lo que ya ha generado. Cuanto más largo es el audio, más pesa lo que él mismo ha producido frente a tu muestra, y cada pequeña desviación arrastra a la siguiente. Al trocear, cada fragmento vuelve a empezar pegado a la muestra.
En un podcast de quince minutos generado de golpe, esa deriva sería un desastre. Escúchalo:
Trocear tiene un precio, pero es pequeño: tardó 88 segundos en lugar de 73, porque genera varios fragmentos y luego los monta, y el audio dura algo más (63 s frente a 55 s) por las pausas entre frases.
Los detalles del troceado que mejor me han funcionado:
- Frases completas en fragmentos de unos 350 caracteres. Cortar frase a frase reinicia la entonación cada pocas palabras y todo suena a lista de la compra. Nunca mezclar dos párrafos en un fragmento, y evitar trozos de menos de 40 caracteres, porque con tan poco texto el modelo entona raro.
- Pausas según la puntuación: unos 190 ms tras una coma, 400 ms tras un punto, 560 ms tras unos puntos suspensivos y 750 ms entre párrafos, con una pequeña variación aleatoria para que no suene a metrónomo.
- Recortar el silencio de los bordes con margen, sin comerse consonantes finales ni respiraciones, y con fundidos muy cortos entre fragmentos.
- Ajustar el volumen una sola vez, al final, sobre el audio completo (−16 LUFS, lo habitual en podcasts), en lugar de normalizar cada trozo y acabar con saltos de volumen.
Lo que creía y no era: la semilla
Mi script de audios largos usaba la misma semilla aleatoria en todos los fragmentos. Lo hice convencido de que así el timbre se mantendría estable de uno a otro.
Lo medí. Con semilla fija, el parecido medio fue de 0,952; con una semilla distinta en cada fragmento, de 0,961. Y la variación entre fragmentos, mínima en los dos casos.
Con Qwen3-TTS y una buena muestra, la semilla no es lo que mantiene la voz. Lo que la mantiene es la muestra y no dejar que el modelo se aleje de ella generando demasiado de una tirada.
Dónde falla
Para contar los errores de lectura transcribí todos los audios con Whisper y los comparé palabra por palabra con el texto pedido. Es un método con trampa, porque Whisper también se equivoca y escribe «20» donde la voz dijo «veinte», así que descarté las diferencias que solo eran de formato.
En textos normales, el modelo grande apenas falla: en el texto largo, cero palabras distintas en las tres repeticiones.
Donde sufre es en el texto difícil, pensado para hacer daño:
«La RTX 2080 SUPER tiene 8 GB de VRAM, salió en 2019 y costaba 719 euros. El 3,5 % de las veces, el modelo lee mal siglas como CTCSS, URL o GPU, y números como 1.080 o 24 kHz.»
- Modelo grande (1.7B): en una de las tres repeticiones leyó «VRAM» de forma irreconocible, y en otra se trabó con «kHz». Los números («2080», «719 euros», «3,5 %», «1.080») los leyó bien.
- Modelo pequeño (0.6B): falló en las tres repeticiones. Leyó «719» como «79» o «709», se comió letras de «CTCSS» y en una ocasión convirtió «1.080 o 24 kHz» en algo ininteligible.
Escuchándolos, la diferencia se oye sin necesidad de Whisper: el modelo grande tropieza poco; el pequeño, mucho.
Si tu texto lleva cifras o siglas, usa el modelo grande. Y aun así, cuando importen, escribe los números en letra y las siglas como quieras que suenen.
Discusión
Juntando todo, el cuadro es bastante claro.
La memoria no es el problema, siempre que la tarjeta sea solo para la voz. Con 8 GB cabe el modelo grande con un margen de 0,7 GB. Lo que no cabe es nada más: ni un modelo de lenguaje, ni Whisper a la vez.
La velocidad no depende del tamaño del modelo, ni siquiera de la gráfica. Los dos tamaños dan los mismos ~200 pasos seguidos por segundo de voz, y quien marca el ritmo es el núcleo del procesador que los va encargando, no la GPU, que trabaja al 40 %. Elegir el modelo pequeño para ir más rápido es un error: pierdes calidad de lectura y no ganas tiempo. Y una gráfica más potente probablemente tampoco ayudaría mucho; un procesador con núcleos más rápidos, seguramente más. Esto último no lo he podido comprobar.
La calidad se decide antes de generar. Una mala muestra no la arregla ningún modelo ni ningún ajuste. Y un audio largo se decide en cómo lo troceas, no en la semilla.
En la práctica, se puede producir un podcast con tu voz en local. Más lento que el tiempo real, con una muestra cuidada y troceando bien, pero sin enviar un solo segundo de tu voz a ningún servidor.
Limitaciones del método
Conviene leer los números con estas reservas:
- Una sola voz. Todo está medido con mi voz y mi muestra. Otras voces, otros idiomas u otras muestras pueden comportarse distinto.
- El parecido lo mide una máquina. La huella de voz de Resemblyzer es útil para comparar resultados entre sí, pero no sustituye a un oyente que conoce la voz. Un 0,95 no significa «engaña al 95 % de la gente».
- Los errores de lectura los cuenta Whisper, que también se equivoca. Por eso descarté las diferencias de formato y por eso conviene escuchar los audios.
- Whisper solo transcribe 30 segundos de golpe a través de Voicebox: en la primera pasada, los audios largos parecían llenos de errores porque simplemente faltaba su final. Para medirlos bien tuve que partirlos por los silencios en trozos de menos de 28 segundos.
- Un solo equipo. Como el ritmo lo marca un núcleo del procesador, con otra CPU los tiempos pueden cambiar bastante más que con otra gráfica. No lo he podido comprobar.
- Tres repeticiones por prueba. Suficiente para ver tendencias claras, no para afinar décimas.
Lo legal y lo ético: clona tu voz, no la de otro
Esto hay que decirlo claro, porque la tecnología ya está al alcance de cualquiera.
Con treinta segundos de audio de un vídeo, un audio de WhatsApp o una llamada, cualquiera puede generar frases que nunca dijiste. Las estafas del tipo «hola mamá, he perdido el móvil, necesito dinero» ya no necesitan solo un mensaje de texto: pueden llegar con tu voz.
Mis reglas, y te recomiendo que sean también las tuyas:
- Clona tu propia voz, o la de alguien que te haya dado permiso expreso.
- Avisa cuando un audio es sintético. Si publicas voz generada, dilo.
- No uses voces ajenas para nada comercial ni para hacerte pasar por nadie.
En España, la voz está protegida como parte del derecho a la propia imagen: la Ley Orgánica 1/1982 considera intromisión ilegítima usar la voz de una persona con fines publicitarios o comerciales sin su consentimiento. Además, una grabación de voz que identifica a alguien es un dato personal a efectos del RGPD. Y el Reglamento Europeo de IA obliga a advertir cuando un audio generado o manipulado con IA imita a personas reales.
Esto no es asesoramiento legal, pero el resumen práctico es sencillo: si no es tu voz y no tienes permiso, no lo hagas.
Y si alguna vez recibes un audio urgente de un familiar pidiéndote dinero, cuelga y llámale tú. Es la mejor defensa, y no requiere ninguna IA.
Si te interesa el otro lado del problema, cómo se intenta detectar el contenido generado por IA y por qué falla tanto, lo expliqué en cómo funciona el fingerprinting de IA.
Qué configuración usaría en 8 GB
- Modelo grande (1.7B) para todo. Va igual de rápido que el pequeño, se parece igual a tu voz y lee mucho mejor los números y las siglas.
- El pequeño (0.6B), solo si tienes que compartir la tarjeta con otra cosa: deja 2,4 GB libres en lugar de 0,7 GB. Pero revisa con lupa las cifras del texto.
- Nada más cargado en la tarjeta. Descarga los modelos de LM Studio o ComfyUI antes de generar voz, y no tengas Whisper y el modelo de voz cargados a la vez.
- Trocea siempre los textos largos en frases completas. Es lo que más se nota en el resultado.
- Cuida la muestra: 15-30 s, buen micrófono, sala silenciosa y transcripción exacta.
Conclusiones: cinco preguntas
¿Se puede clonar una voz en local con 8 GB de VRAM? Sí. El modelo grande de Qwen3-TTS cabe con 0,7 GB de margen en una RTX 2080 SUPER, siempre que no haya nada más cargado en la tarjeta.
¿Es rápido? No llega al tiempo real: unos 1,35 segundos por cada segundo de audio. Un podcast de 15 minutos son unos 20 de generación.
¿Compensa el modelo pequeño? No. Tarda lo mismo, porque da los mismos pasos seguidos y el que marca el ritmo es un núcleo del procesador, no la gráfica. Y lee peor. Solo ahorra memoria.
¿Se mantiene la voz en un audio largo? Solo si lo troceas. Generado de golpe, el parecido con tu voz cae de forma clara en menos de un minuto.
¿Qué es lo más importante? La muestra. Ninguna configuración arregla una muestra de radio, ruidosa o demasiado corta.
Lo difícil no es que el modelo hable con tu voz. Eso lo hace a la primera.
Lo difícil es todo lo demás. Y es justo lo que separa un audio que impresiona diez segundos de uno que puedes escuchar entero.
Sigue explorando la IA local
- IA local frente a la nube: privacidad, potencia y límites reales.
- Diarización local con WhisperX en 8 GB, el camino inverso: de voz a texto.
- Cuál es el mejor modelo de IA local: 13 modelos frente a 1.080 pruebas.
- TRELLIS 2 en 8 GB, otra prueba de hasta dónde llega una tarjeta de 2019.
Preguntas frecuentes
¿Cuántos segundos de audio necesito para clonar una voz?
Entre 15 y 30 segundos de una grabación limpia. En mis pruebas, con solo 5 segundos el parecido bajó de 0,956 a 0,893, y por encima de 30 o 40 segundos no mejora y cada generación se vuelve más lenta.
¿Se puede clonar una voz sin conexión a Internet?
Sí. Una vez instalado Voicebox y descargado el modelo, la clonación y la generación funcionan completamente en local. Ni la muestra ni el texto salen de tu equipo.
¿Cuánta VRAM necesita Qwen3-TTS?
En una RTX 2080 SUPER, el modelo grande (1.7B) ocupó unos 5,6 GB y el pequeño (0.6B) unos 3,8 GB, sin contar lo que ya ocupe el escritorio. En una tarjeta de 8 GB, el grande cabe, pero sin margen para nada más.
¿Es más rápido el modelo 0.6B que el 1.7B?
En mi equipo, no. Los dos tardan unos 1,35 segundos por segundo de audio: tienen las mismas 28 capas y dan los mismos pasos seguidos, y el ritmo lo marca un núcleo del procesador al 100 % mientras la gráfica trabaja al 40 %. El pequeño solo es más estrecho.
¿Funciona sin GPU NVIDIA?
No lo he probado: todas las mediciones de este artículo están hechas con una GPU NVIDIA. Voicebox puede funcionar sin ella, pero no tengo datos de velocidad en CPU.
¿Es legal clonar una voz?
Clonar tu propia voz, sí. Clonar la de otra persona sin su consentimiento puede vulnerar su derecho a la propia imagen (que en España incluye la voz) y la protección de datos, sobre todo si se usa con fines comerciales o para suplantarla.
¿Por qué mi voz clonada suena apagada o con eco?
Casi siempre por la muestra: ruido de fondo, una sala con eco o un micrófono que corta los agudos. El modelo reproduce todo lo que oye en la referencia. Graba otra muestra en un lugar silencioso y con un buen micrófono.