125.000 millones de parámetros en dos GPU de 8 GB y 6 GB: Qwen3.8-Flash-Next con Strata
En octubre probé Strata por primera vez, no conseguí buenos resultados y lo desinstalé. Lo conté en mi artículo sobre la caché de expertos. Ahora lo he vuelto a instalar para ejecutar Qwen3.8-Flash-Next con 8 GB VRAM en una gráfica y 6 GB en otra.
Hay un detalle que me hacía dudar: los equipos de ejemplo que publica el proyecto parten de tarjetas de 12 GB de VRAM (una RTX 3060, una RTX 5070). Yo tengo una RTX 2080 SUPER de 8 GB y una RTX 2060 de 6 GB, dos generaciones distintas, 14 GB entre las dos. ¿Se puede ejecutar un modelo de 125.000 millones de parámetros con doble GPU y tan poca VRAM? Spoiler: sí, y a unos 34 tokens por segundo.
Qwen3.8-Flash-Next sigue siendo, a día de hoy, lo mejor que he visto para ejecutar en local, y me había quedado con la espina clavada. Esta vez con una meta clara: que no fuera una demo, sino el motor de un agente de verdad dentro de mi propia aplicación.
Este artículo cuenta tres cosas: cómo funciona Strata en mi equipo y qué ajustes marcaron la diferencia, cómo lo integré en Agente Jiménez con un agente nuevo, Adolfo-Strata, y qué es capaz de hacer, con un ejemplo real: le pedí que programara un videojuego 2D en HTML y lo comprobé.
Este artículo continúa mi prueba de la caché de expertos, donde explico qué es un modelo MoE y por qué un modelo enorme puede caber en una gráfica pequeña. El hardware y la forma de medir son los de mi primer artículo sobre programación autónoma. No repito ese contexto: si te hace falta, empieza por ahí.
Resumen de resultados
| Pregunta | Respuesta medida |
|---|---|
| ¿Funciona Qwen3.8-Flash-Next en una RTX 2080 SUPER (8 GB) + una RTX 2060 (6 GB)? | Sí. Entre 33 y 34 tokens por segundo generando, con la configuración final |
| ¿Qué ajuste dio casi toda la mejora? | STRATA_ROUTE_PRIOR=1.5: de +21 % en texto a +63 % generando tras un prompt largo |
| ¿Tiene algún coste? | Sí: me coló caracteres chinos en mitad de palabras en castellano. Lo resolví vetando esos tokens en cada petición, sin perder velocidad |
| ¿Y el MTP, la decodificación especulativa? | Conseguí que arrancara, pero no acelera y tumba el motor con un prompt largo. Descartado |
| ¿Sirve como motor de un agente? | Sí. Adolfo-Strata ejecuta comandos y busca en la web. Le encargué un videojuego 2D y cumple los 11 requisitos del encargo |
| ¿Y con la prueba oficial de Strata? | Más modesta: 27,5 tok/s en chat, 18 tok/s como agente y 36,5 tok/s leyendo un prompt de 16K, que tarda unos 7 minutos en dar la primera palabra |
| ¿Dónde se nota el esfuerzo? | Al leer prompts largos. El turno de confirmación del juego tardó casi 7 minutos |
Strata 0.2.9 · Qwen3.8-Flash-Next Gyro-S · RTX 2080 SUPER + RTX 2060 · Ryzen 7 5800X · 32 GB de RAM · dos pasadas por prueba, una para el prompt largo.
¿Qwen3.8-Flash-Next con 8 GB VRAM? ¿Y con dos GPU de 8 y 6 GB?
Con dos GPU de 8 GB + 6 GB, sí, siempre que tengas RAM y un NVMe rápido: yo uso 32 GB de RAM y un disco a ~2,5 GB/s. Strata reparte las capas del modelo entre las dos gráficas, aunque sean de generaciones distintas (una RTX 2080 SUPER y una RTX 2060), y deja el resto de los expertos en la RAM y el disco. Con una sola gráfica de 8 GB no lo he medido en esta prueba, así que no te prometo nada.
El precio: leer prompts largos es lento. Todo está medido más abajo, también con la prueba oficial del proyecto.
Antes de empezar: cuatro ideas sencillas
- Strata. Un servidor local que ejecuta modelos MoE enormes en tarjetas pequeñas. Reparte las capas del modelo entre las gráficas y deja los expertos que no caben en la RAM y en el NVMe, de donde los trae cuando hacen falta. Habla como la API de OpenAI, así que cualquier programa que sepa hablar con OpenAI puede usarlo.
- Gyro-S. La versión muy comprimida de Qwen3.8-Flash-Next que usa Strata. Pesa 58,5 GB, unos 2,6 bits por peso de media. Es el formato propio de Strata: no lo carga el llama.cpp normal.
- MTP (predicción de varios tokens). El modelo propone de golpe varias palabras siguientes y comprueba si acierta. Si acierta, avanza varias de una vez. Es una técnica de velocidad.
- Veto de tokens (
logit_bias). Una opción de la API para decirle al modelo «esta palabra, ni se te ocurra». Más abajo la uso con un fin muy concreto.
Mi equipo: dos GPU de 8 GB y 6 GB (RTX 2080 SUPER + RTX 2060)
| Pieza | Qué tengo |
|---|---|
| Gráficas | RTX 2080 SUPER (8 GB, además mueve el escritorio y ocupa ~1,5 GB) + RTX 2060 (6 GB, en un PCIe x4) |
| Procesador | Ryzen 7 5800X. Tiene AVX2 pero no AVX-512 |
| Memoria y disco | 32 GB de RAM · NVMe a unos 2,5 GB/s |
| Sistema | Garuda Linux |
| Strata | Aplicación 0.2.9 y motor 0.1.55 (CUDA 13), instalada aislada, con su propio directorio de datos |
| Modelo | Qwen3.8-Flash-Next Gyro-S: 58,5 GB, más el paquete de expertos y la capa de MTP. En total, unos 90 GB en disco |
| Contexto | 32.768 tokens |
Strata detecta que mi RAM no da para tener todo en memoria y activa solo su «modo de poca RAM»: los expertos se leen del NVMe a través de la caché de páginas del sistema. Por eso la RAM libre importa tanto, como verás en los resultados.
El modelo, en números
Para saber con qué trabajaba leí la cabecera del archivo del modelo y sumé el tamaño de cada tensor. No son cifras oficiales de Qwen, son las que salen de mi archivo.
| Parte | Parámetros |
|---|---|
| Expertos: 48 capas de 512, de los que usa 10 por token | 120,8 B |
| Tabla de embeddings por capa (se consultan solo unas filas por token) | 51,2 B |
| Atención, capas SSM, experto compartido, entrada y salida | 4,9 B |
| Total | 176,9 B |
Sin esa tabla de embeddings, que no se multiplica por token, quedan unos 126 B. Es la cifra de «125B» que citaba en el artículo anterior. En cada token trabajan unos 6,6 B, que es lo que explica que pueda ir tan rápido.
Cómo lo ajusté
Partí de la primera configuración que me arrancó y fui comparando. Esto es lo que quedó:
| Ajuste | Para qué sirve | Efecto en mi equipo |
|---|---|---|
STRATA_ROUTE_PRIOR=1.5 | Prefiere los expertos que ya están en la gráfica. Viene apagado desde la 0.2.8 porque causaba texto repetido en sesiones largas | Casi toda la mejora de velocidad |
| KV de 8 bits (int8) | Guarda la memoria de la conversación con menos precisión, para que ocupe menos | Libera VRAM y deja sitio a los expertos |
--gpus 0,1 | Reparte las capas entre las dos tarjetas. Probé el papel de «ayudante» para una de ellas y Gyro no lo admite: Strata acababa cargándolo todo en la 2080 | Usa las dos gráficas de verdad |
--vram-reserve-mib 400 | Deja libre un poco de VRAM para el escritorio | Evita quedarse sin memoria con la pantalla en uso |
--mtp off | Desactiva la predicción de varios tokens | Ver más abajo: no compensa |
Además pasé el afinador automático de Strata (strata tune auto). Concluyó que no había nada más rápido que mi configuración.
Resultados
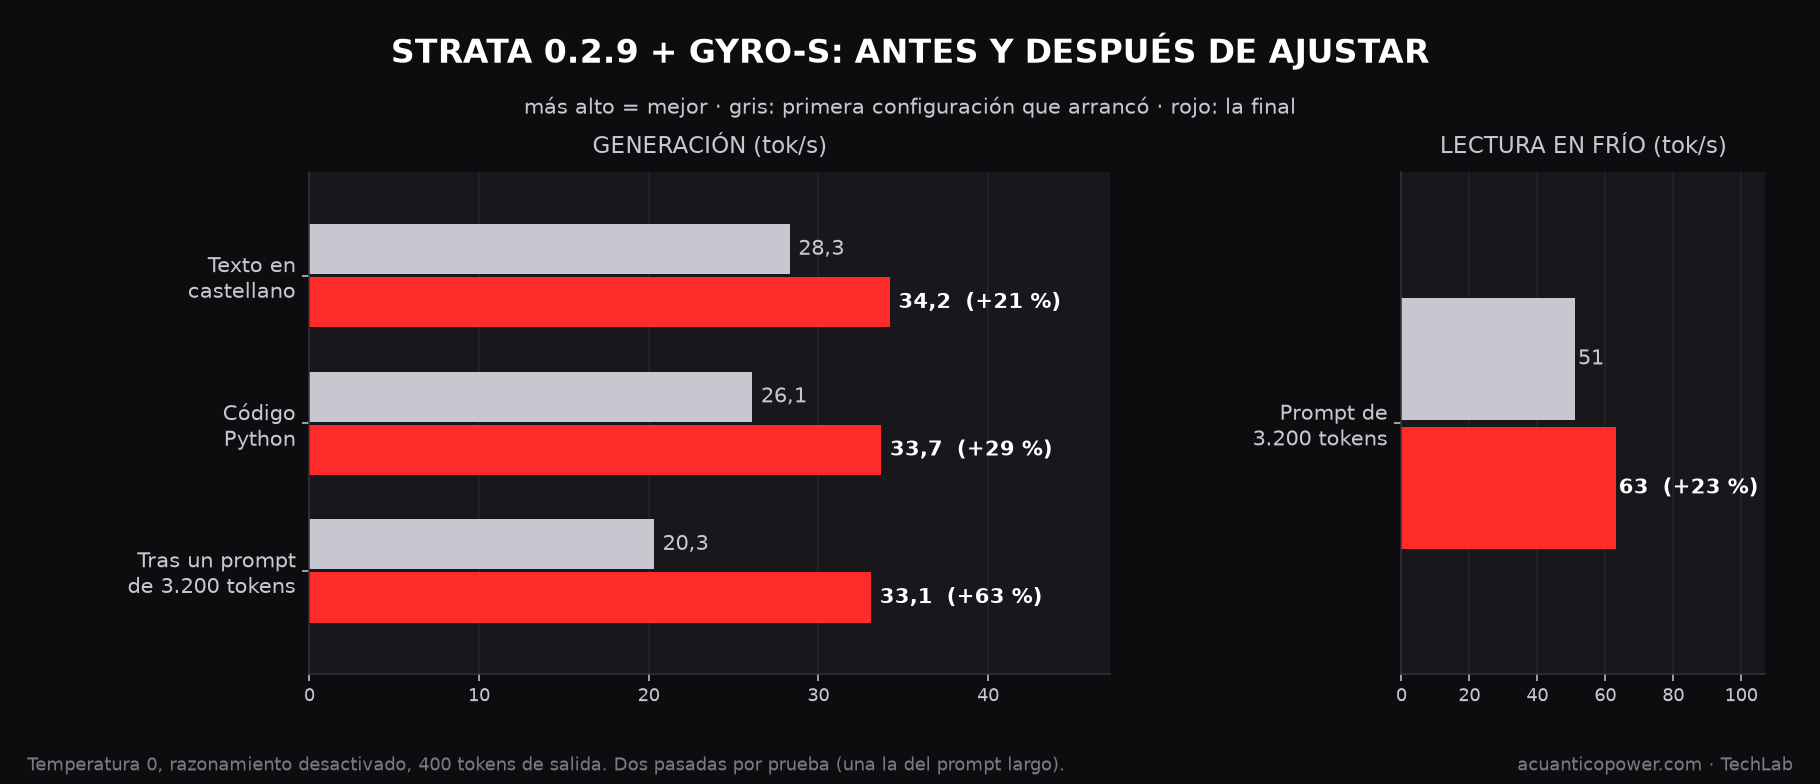
| Prueba | Antes | Después | Cambio |
|---|---|---|---|
| Texto en castellano | 28,3 tok/s | 34,2 tok/s | +21 % |
| Código Python | 26,1 tok/s | 33,7 tok/s | +29 % |
| Generación tras un prompt de 3.200 tokens | 20,3 tok/s | 33,1 tok/s | +63 % |
| Lectura de ese prompt, en frío | 51 tok/s | 63 tok/s | +23 % |
Con la caché de páginas ya caliente, ese mismo prompt se lee a 106-165 tok/s. «Antes» es la primera configuración que me arrancó (KV q4_0, sin MTP); «después», la final.
En cristiano: lo que cuesta no es escribir, sino leer. Generar va sobre 34 tok/s, una velocidad cómoda. Leer un prompt largo depende de que los expertos estén ya en la RAM, y con 32 GB hay poco margen. La prueba oficial lo confirma: 16K de contexto tardan unos 7 minutos en dar la primera palabra.
El precio de ir más rápido: caracteres chinos
Con STRATA_ROUTE_PRIOR activado, apareció una palabra china en mitad de una frase en castellano: «sea吸入ado». Salió igual en las dos pasadas de la prueba de texto (con temperatura 0 el resultado se repite). Sin la opción, en las mediciones de referencia, no apareció.
No quise renunciar a la mejora, así que la corregí en el cliente. En cada petición mando un logit_bias de −100 para los 66.394 tokens chinos, japoneses y coreanos del vocabulario del modelo (los saqué del vocab.json del propio paquete). El modelo sencillamente no puede elegirlos. No cuesta velocidad medible.
El MTP: lo conseguí y lo descarté
Tenía curiosidad por el MTP. Con 8 GB, la capa de borrador (~825 MiB) no cabe en la 2080 junto al escritorio, así que había que llevarla a la 2060. Esto es lo que hizo falta:
--pipeline-windows 2, para que la capa de borrador se pueda mover.- La variable
STRATA_MTP_STAGE0=1. Las notas de la versión dicen que con las ventanas en tubería la capa va a la primera tarjeta, pero en mi equipo, con NVIDIA y dos gráficas, no pasó. El motor lo explica en su registro: hay que pedirlo con esa variable. - Fijar a mano el reparto de capas (
--layer-split 7), limitar la caché de expertos (--expert-cache 150) y reducir el bloque de lectura (--prefill 512).
Arrancó y aceptaba la mitad de los borradores. Pero no aceleraba: 23-26 tok/s, igual o peor que sin él. Y con un prompt de 3.200 tokens, el motor se cayó por falta de VRAM. Cuando los expertos vienen de la RAM o del disco, el límite es traerlos, no el número de pasadas. Coincide con lo que contaban otros usuarios con tarjetas de 6 GB en las incidencias #474 y #916 del proyecto.
La prueba oficial de Strata
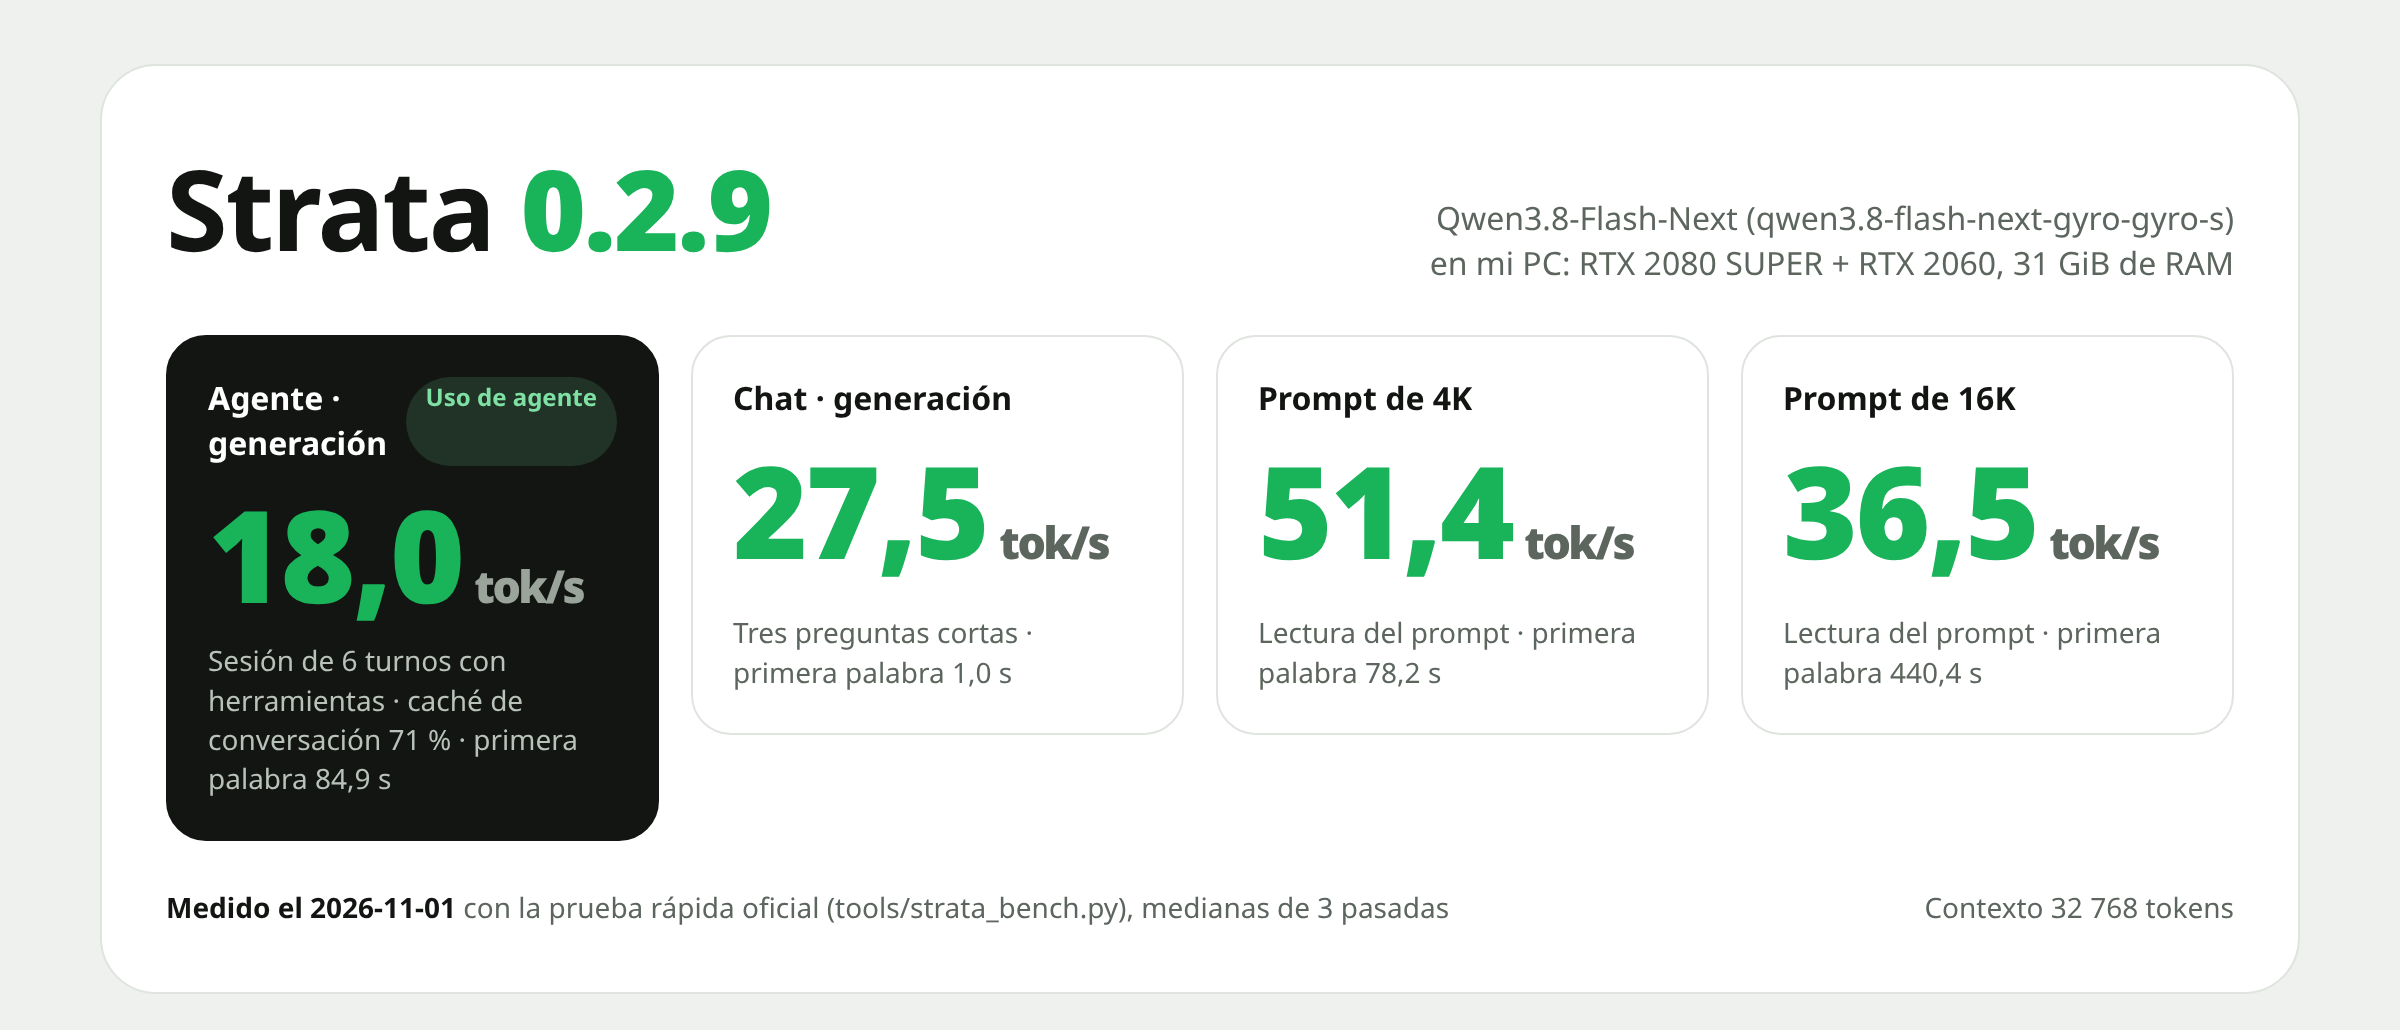
Las cifras de arriba son mis mediciones. Quise contrastarlas con la prueba rápida oficial del proyecto (tools/strata_bench.py), que usa prompts nuevos en cada pasada, así que la caché no ayuda. Son medianas de 3 pasadas:
| Prueba | Mediana | Rango |
|---|---|---|
| Chat, 3 preguntas cortas (100 tokens): generación | 27,5 tok/s | 22,7 – 28,6 |
| Chat: primera palabra | 1,05 s | 0,93 – 1,26 |
| Prompt de 4K: lectura | 51,4 tok/s | 35,7 – 58,6 |
| Prompt de 4K: primera palabra | 78 s | 69 – 113 |
| Prompt de 16K: lectura | 36,5 tok/s | 32,7 – 46,9 |
| Prompt de 16K: primera palabra | 440 s (7,3 min) | 343 – 492 |
| Agente, sesión de 6 turnos con herramientas: generación | 18 tok/s | 11 – 26 |
| Agente: primera palabra por turno | 85 s | 50 – 151 |
| Agente: aciertos de la caché de conversación | 71 % | 70,7 – 70,8 |
Son más bajas que mis mediciones (34 tok/s en texto frente a 27,5 en chat). No las he investigado a fondo. Las pruebas no son iguales: la oficial genera solo 100 tokens por pregunta, con prompts nuevos cada vez, y la mía 400 tokens. Y el rango es amplio: la primera pasada del chat fue la más lenta y las siguientes subieron hasta 28,6, con los expertos cada vez más presentes en la RAM.
Lo que sí deja claro es dónde está el límite: leer. Con 16K de contexto, la primera palabra tarda de 6 a 8 minutos. Como agente, con una sesión que crece turno a turno, cada turno tarda más de un minuto en empezar a responder.
Una advertencia: el informe automático de la prueba detectó solo una gráfica (la RTX 2060) en su ficha de máquina, así que esa ficha no es fiable. La medición se hizo con las dos tarjetas, como el resto del artículo.
Cómo lo integré en Agente Jiménez
Agente Jiménez es mi aplicación de agentes locales. Cada agente tiene su propio modelo, sus herramientas y su manera de arrancar, y no toca a los demás. Añadí uno nuevo, Adolfo-Strata, que habla con Strata.
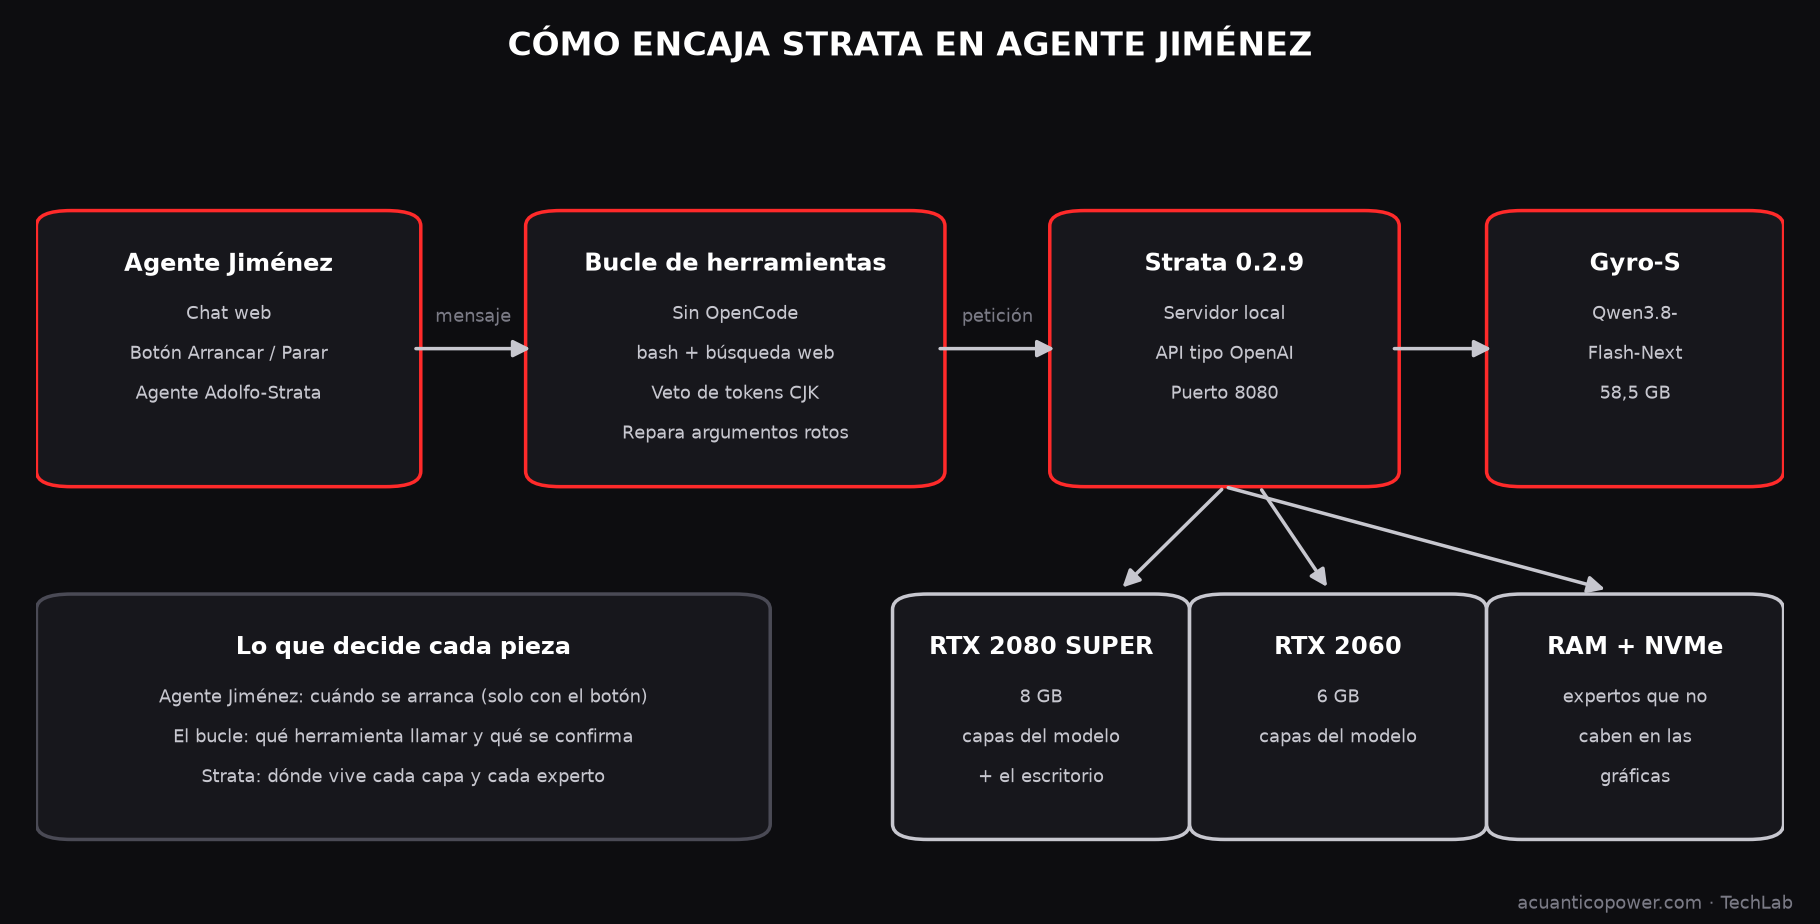
Quise un flujo directo, como el de mi agente Adolfo-Assistant, sin OpenCode por medio. En el artículo anterior, la primera petición de OpenCode ya ocupaba 34.005 tokens, y con un modelo al que lo que más le cuesta es leer, prefiero mandarle poco.
- Un bucle de herramientas propio. Adolfo-Strata puede ejecutar comandos de shell y buscar en la web. Pide confirmación antes de lo delicado, como el resto de mis agentes.
- Un botón «Arrancar Strata» / «Parar Strata» en la barra superior, con su estado (parado, arrancando, listo). Ningún agente carga modelos por su cuenta: solo lo hace el botón.
- Gestión de memoria. Antes de arrancar, si LM Studio está abierto con un modelo cargado, lo descarga para dejar libre la VRAM. Si está cerrado, ni lo toca. El protector de recursos de Agente Jiménez reconoce el proceso de Strata.
- El veto de tokens chinos que acabo de contar, enviado en cada petición.
- Selector de modelo bloqueado: este agente solo usa el modelo que Strata tiene cargado, que es lo que se muestra.
Arrancar Strata desde cero tarda unos 13-15 segundos con el modelo ya en disco. Una petición sencilla que ejecuta un comando, de punta a punta, llevó unos 27 segundos.
Tres trampas que aparecieron al usarlo
Los dos primeros intentos de la prueba del videojuego (la siguiente sección) fallaron. Lo que descubrí merece un apartado:
- Respuesta vacía. El modelo escribió el archivo completo dentro de la llamada a la herramienta, pero con secuencias de escape mal formadas en el JSON. Mi código no podía leerlo y lo descartaba, así que no hacía nada. Ahora, para este agente, intenta reparar los escapes. Si aun así no hay comando, le pide que lo repita. Y la respuesta final nunca queda vacía.
- El filtro de seguridad pedía confirmación sin motivo. Mi filtro de comandos vio la palabra «su» dentro del HTML del juego y la tomó por una orden. Ahora ignora el contenido de los heredoc que solo escriben un archivo. Si ese contenido se pasa a
bashosh, o se escribe en/etc, sigue pidiendo confirmación. - Un límite de salida corto. Un juego completo ocupa miles de tokens. Subí el máximo por turno de este agente.
La prueba: que programe un videojuego
Quería una tarea que se pudiera comprobar de verdad, no con una impresión. Elegí un matamarcianos clásico en un único archivo HTML, por varias razones:
- Todo el mundo sabe cómo debe verse, así que se juzga a ojo y sin explicaciones.
- Es autocontenido: sin librerías ni imágenes. Todo se dibuja con formas del canvas.
- Obliga a coordinar cosas distintas a la vez: bucle de juego, colisiones, estado, puntos, niveles y persistencia.
- Se puede automatizar: se abre en un navegador sin ventana, se juega con el teclado y se registran los errores de JavaScript.
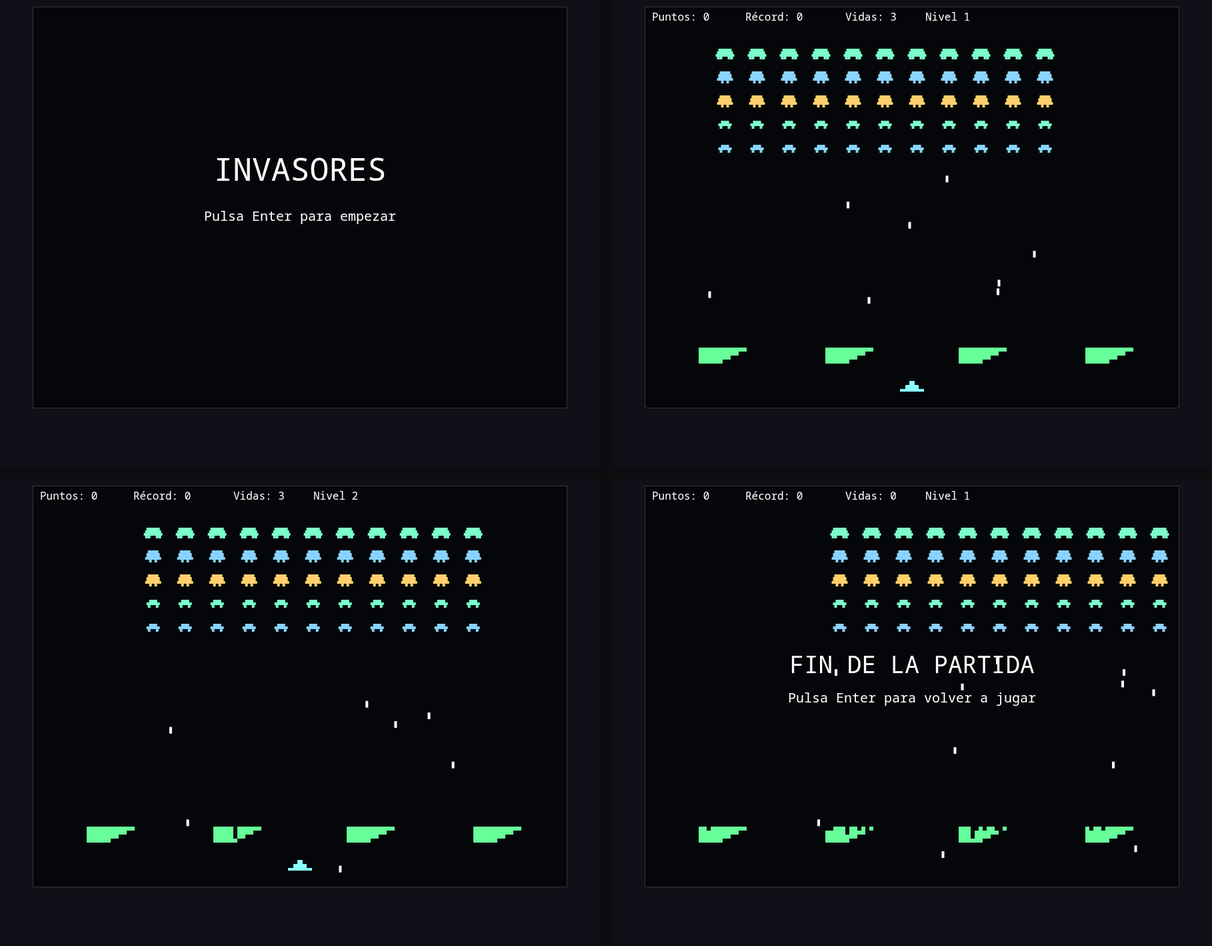
El encargo tenía 11 requisitos concretos: un canvas de 800×600; una pantalla de inicio con «INVASORES»; una nave que se mueve con las flechas y dispara; una formación de 5×11 invasores con tres dibujos y puntos distintos; invasores que disparan desde la fila de abajo; cuatro escudos destructibles; marcador con récord guardado en localStorage y tres vidas; siguiente nivel más rápido; fin de partida; pausa con la tecla P; y todos los textos en español de España.
Pruébalo tú mismo
Este es el archivo tal cual lo escribió Adolfo-Strata, sin retocar una línea. Haz clic dentro del juego para darle el foco y pulsa Enter para empezar. Se mueve con las flechas o con A y D, se dispara con la barra espaciadora y se pausa con P. Necesita teclado.
Aquí el récord solo dura mientras no cierres la página. Ya sabes lo que te espera: es difícil.
Lo que hizo
| Qué se comprobó | Resultado |
|---|---|
| Archivo generado | Un solo HTML de unas 370 líneas (10,8 KB), con CSS y JavaScript dentro, creado por Adolfo-Strata con un único comando |
| Los 11 requisitos | Cumplidos. En la comprobación automática: puntos (llegó a 150), récord guardado, pausa, paso al nivel 2, reinicio tras la derrota y textos en castellano |
| Errores de JavaScript | Ninguno |
| Tiempo de generación | 239 segundos, unos 4 minutos |
| Turno de confirmación | 407 segundos: Strata tuvo que releer unos 10.000 tokens de la conversación |
Lo que no hizo bien
- Es demasiado difícil. En mi comprobación automática se perdían las tres vidas en unos 23 segundos.
- Los escudos tienen una forma rara, con los bloques desordenados. Funcionan, pero no parecen escudos.
- El modelo no probó nada de lo que escribió: solo comprobó que el archivo existía y contó sus líneas, como pedía el encargo. Las pruebas de verdad las hice yo.
En cristiano: a un modelo comprimido a unos 2,6 bits, en 14 GB de gráfica, le pides un juego entero y te lo escribe a la primera, sin errores y cumpliendo todo lo que has pedido. No te lo deja equilibrado, pero funciona.
¿Merece la pena?
| Si tienes… | Mi recomendación |
|---|---|
| Dos gráficas pequeñas (8 + 6 GB), 32 GB de RAM y un NVMe rápido | Sí merece la pena probarlo: generar a unos 34 tok/s con un modelo de este tamaño es una buena velocidad |
| Tareas con muchísimo contexto o conversaciones largas | Cuidado: leer el prompt es lo lento. Con 16K de contexto la primera palabra tarda unos 7 minutos en la prueba oficial. Cuanta más RAM libre, mejor |
| Mucha prisa | Un MoE de 26-35B que quepa entero, como Cyber-Tiel, es más rápido. Qué modelo escribe mejor es otra pregunta: no los he comparado en calidad |
| Ganas de ajustar | Prueba STRATA_ROUTE_PRIOR=1.5, pero vigila los caracteres extraños, o veta los tokens que no quieras ver |
| Una gráfica de menos de 12 GB y ganas de MTP | Calcula antes si cabe la capa de borrador. En la mía no acelera |
Qué no he medido
- Las velocidades son de pocas pasadas (dos por prueba, una para el prompt largo). Tómalas como orientativas.
- La prueba oficial que sí he pasado es la rápida (
strata_bench.py), no la estándar (strata bench run). Los resultados no son comparables con los de la suite estándar del proyecto. - El videojuego es una sola tarea, generada una vez, y la calidad la he juzgado yo, con una comprobación automática y alguna partida a mano.
- Gyro-S está muy comprimido: va bien en castellano y en código sencillo, pero no es el modelo original.
- No he comparado la calidad de Flash-Next con la de Cyber-Tiel en las mismas tareas.
- Strata y Gyro-S no son material mío: es la herramienta de otro proyecto y estas cifras son solo mis mediciones.
Qué me llevo
Con Strata 0.2.9, Qwen3.8-Flash-Next deja de ser una demo y se convierte en algo que se puede usar como motor de un agente, con un modelo de unos 125.000 millones de parámetros (177.000 si cuentas la tabla de embeddings) repartido entre dos gráficas modestas.
No es un modelo rápido leyendo, ni un programador perfecto: te escribe un juego a la primera, pero demasiado difícil. Pero está ahí, funciona y se puede ajustar.
Si quieres entender mejor las piezas, qué es un MoE y por qué la caché de expertos de llama.cpp no me funcionó, lee la prueba anterior.
Si te ha servido, invítame a un café
Estas pruebas se llevan horas de máquina y decenas de gigas de modelos que descargo, mido y borro. Lo único que no sé generar en local es el café.
Si este artículo te ha ahorrado probarlo tú, puedes invitarme a uno.
Montar esto me llevó una tarde de ajustes, unos 90 GB en disco y más de un arranque fallido. Un café ayuda a seguir probando.
☕ Invítame a un café en Ko-fiSigue explorando la IA local
- Caché de expertos en llama.cpp, la prueba en la que desinstalé Strata y de la que este artículo es continuación.
- Programación autónoma con IA local: ¿bastan 8 GB de VRAM para programar con modelos de 30B?
- IA local por dentro: qué hay realmente detrás de un agente de inteligencia artificial.
- ¿Cuál es el mejor modelo de IA local? 13 modelos frente a 1.080 pruebas.
- Música con IA local en 8 GB, otra prueba de hasta dónde llega una gráfica de 8 GB.
Preguntas frecuentes
¿Puedo ejecutar Qwen3.8-Flash-Next con una gráfica de 8 GB y otra de 6 GB?
Sí, con Strata 0.2.9, la versión Gyro-S, 32 GB de RAM y un NVMe. Yo llego a unos 34 tok/s generando. Lo lento es leer prompts largos.
¿Se puede usar doble GPU con tarjetas distintas, como una RTX 2080 SUPER y una RTX 2060?
Sí. Con --gpus 0,1 Strata reparte las capas entre las dos, aunque tengan distinta VRAM (8 GB y 6 GB) y distinta generación. La 2060 va en un PCIe x4 y no fue un problema. Lo que no admitió fue darle a una de ellas el papel de «ayudante»: con Gyro-S acababa cargándolo todo en la 2080.
¿Cuánta RAM y cuánto disco hacen falta para Qwen3.8-Flash-Next en Strata?
En mi caso, 32 GB de RAM y unos 90 GB de disco (el modelo de 58,5 GB, el paquete de expertos y la capa de MTP). Cuanta más RAM libre, más rápido lee los prompts: con la caché ya caliente subí de 63 a 106-165 tok/s.
¿Funciona con una sola gráfica de 8 GB?
No lo he medido en esta prueba. Los ejemplos del proyecto parten de tarjetas de 12 GB; yo lo hice con dos gráficas (8 GB + 6 GB).
¿Qué es STRATA_ROUTE_PRIOR?
Una variable que hace que Strata prefiera los expertos que ya están en la gráfica. Está apagada por defecto desde la 0.2.8 por un riesgo de texto repetido en sesiones largas. Se activa con STRATA_ROUTE_PRIOR=1.5 en el bloque "env" del archivo de configuración del modelo.
¿Merece la pena el MTP con 8 GB de VRAM?
En mi equipo no. Hay que mover la capa de borrador a la segunda gráfica con una variable que el motor solo cita en su registro, arranca, acepta la mitad de los borradores y no acelera, y se cae con prompts largos.
¿Por qué el agente no usa OpenCode?
Quise un flujo directo, como el de mis otros agentes. Mi razón principal es que OpenCode manda un prompt muy grande y a este modelo es leer lo que más le cuesta.
¿Por qué vetar los tokens chinos en vez de no usar la opción?
Porque la mejora de velocidad era casi toda la ganancia y el veto no cuesta nada medible. Es una solución del lado del cliente: no cambia Strata.