Música con IA local en 8 GB: voz y letra con ACE-Step 1.5 en una RTX 2080 SUPER
Hacer música con IA local, una canción entera con su voz, su letra y su estribillo, sin pagar un céntimo y sin subir una sola nota a la nube.
Hace unos años era ciencia ficción. Hoy lo hace un modelo de código abierto en una gráfica que salió en 2019.
Con ACE-Step 1.5 escribes una descripción del estilo, pegas una letra con sus [Verse] y sus [Chorus], eliges el idioma y el modelo te devuelve una canción cantada. Sin suscripción, sin límite de pistas al mes y sin que tu letra salga de tu equipo.
Los servicios en la nube llevan tiempo vendiendo esto. La letra, el estilo y el resultado se quedan en el servidor de otro, y la canción tiene las condiciones de otro.
Así que la pregunta que me interesaba era otra:
¿Puede una RTX 2080 SUPER de 8 GB hacer una canción con voz y letra en español, en local, y qué hay que tocar para que no reviente?
No me vale con que arranque.
He generado canciones en dos versiones del modelo, en dos tarjetas gráficas y con tres configuraciones de arranque.
He medido los tiempos y la memoria.
He provocado y documentado el error de memoria que aparece en 8 GB.
He pasado Whisper sobre la voz separada de cada canción para ver cuánta letra se entiende.
He medido el volumen antes y después de masterizar.
Y he comprobado, con la forma de onda, si el modelo hace de verdad una intro suave que sube y explota cuando se lo pido.
Por el camino aparecieron un par de sorpresas. Una tiene que ver con la memoria y otra con algo que Whisper no ve y el oído sí.
Resumen de resultados
| Pregunta | Respuesta medida |
|---|---|
| ¿Cabe la música con IA local en 8 GB? | Sí, pero con trampa: el modelo de lenguaje de ACE-Step 1.5 ocupa unos 4,5 GB y no cabe entero; hay que arrancar ComfyUI con --fp16-text-enc y --reserve-vram 1.5. Sin eso, se queda sin memoria |
| ¿Cuánto tarda? | Entre 2,3 y 2,8 segundos de cálculo por cada segundo de canción: una de 75 s tarda unos 3 minutos y una de 2 minutos, unos 5 y medio |
| ¿Y en una RTX 2060 de 6 GB? | También funciona, pero 3,6 veces más lento: 631 s para 75 s de canción |
| ¿Cuánta RAM usa? | ComfyUI llegó a ocupar 14,4 GB de RAM: el modelo de lenguaje trabaja a ratos desde la memoria del sistema |
| ¿Se entiende lo que canta? | Whisper reconoce entre el 67 % y el 94,5 % de la letra según el modelo, pero esa nota no mide si la canción suena bien |
| ¿Y con otros estilos y voces? | Diez muestras de 30 s (cinco en inglés y cinco en español): cada una tardó entre 90 y 150 s en estar terminada. Dos salieron sin letra inteligible con la primera semilla y las regeneré; siete de diez superan el 55 % de letra reconocida |
| ¿Qué modelo suena mejor? | A mi oído, ACE-Step 1.5 turbo. La 1.0, con la que compuse la banda sonora de mi videojuego, no me convence cuando hay voz |
| ¿Hace una intro suave que sube y explota? | A medias: hace la intro, un corte de unos 2 segundos y una entrada a plena potencia, pero no una subida gradual |
ACE-Step 1.5 turbo en ComfyUI 0.38 · RTX 2080 SUPER de 8 GB · 32 GB de RAM · una medición por configuración.
Antes de seguir, una advertencia: esto no es un tutorial de «pulsa aquí y ya». Es un experimento con datos, hecho con mi hardware y con mis oídos. Los tiempos son de mi equipo. Lo que sí se puede reproducir es el método y el flujo, que explico paso a paso al final.
Qué es ACE-Step y por qué me interesa
ACE-Step es un modelo de generación de música de código abierto; los ficheros que usa ComfyUI declaran licencia Apache-2.0 en su ficha de Hugging Face. En mi artículo del videojuego de cartas conté cómo compuse con él las 39 pistas de la banda sonora, en una RTX 2060, con la versión 1.0 y sin voz. Aquel flujo vivía en scripts sueltos.
Esta vez hay dos cambios. El primero es que lo he convertido en un agente con vista propia, Adolfo-BPM, dentro de Agente Jiménez, mi panel de agentes locales. El segundo es que he pasado a la versión 1.5, que admite letra en varios idiomas.
Hay dos versiones en juego:
- ACE-Step 1.0: 3.500 millones de parámetros, según el nombre del propio fichero. El fichero ocupa 7,7 GB. Es el que usé para la banda sonora.
- ACE-Step 1.5 turbo: viene en un único fichero «todo en uno» de 10 GB que incluye el modelo de difusión, los codificadores de texto y el decodificador de audio. Es la variante «turbo», pensada para generar en 8 pasos en lugar de 50.
Un detalle importante. La 1.5 añade, dentro del nodo que lee el texto, un modelo de lenguaje que planifica la canción antes de generarla. El propio nodo lo describe así: genera «códigos de audio», es lento y mejora la calidad. Esa pieza será la protagonista de los problemas de memoria.
Qué hardware he usado
- RTX 2080 SUPER de 8 GB: la tarjeta principal. También mueve mi escritorio, así que nunca tengo los 8 GB libres.
- RTX 2060 de 6 GB: la segunda tarjeta, para las pruebas de comparación.
- 32 GB de RAM y ComfyUI 0.38 instalado con Pinokio.
Ninguna de las dos tarjetas es nueva. La 2080 SUPER es una Turing de 2019, y eso, como pasó con TRELLIS, importa.
Anatomía de una canción generada en local
Antes de medir, quería entender qué pasa por dentro. La canción pasa por ocho etapas, y las tres primeras son la parte que tú escribes:
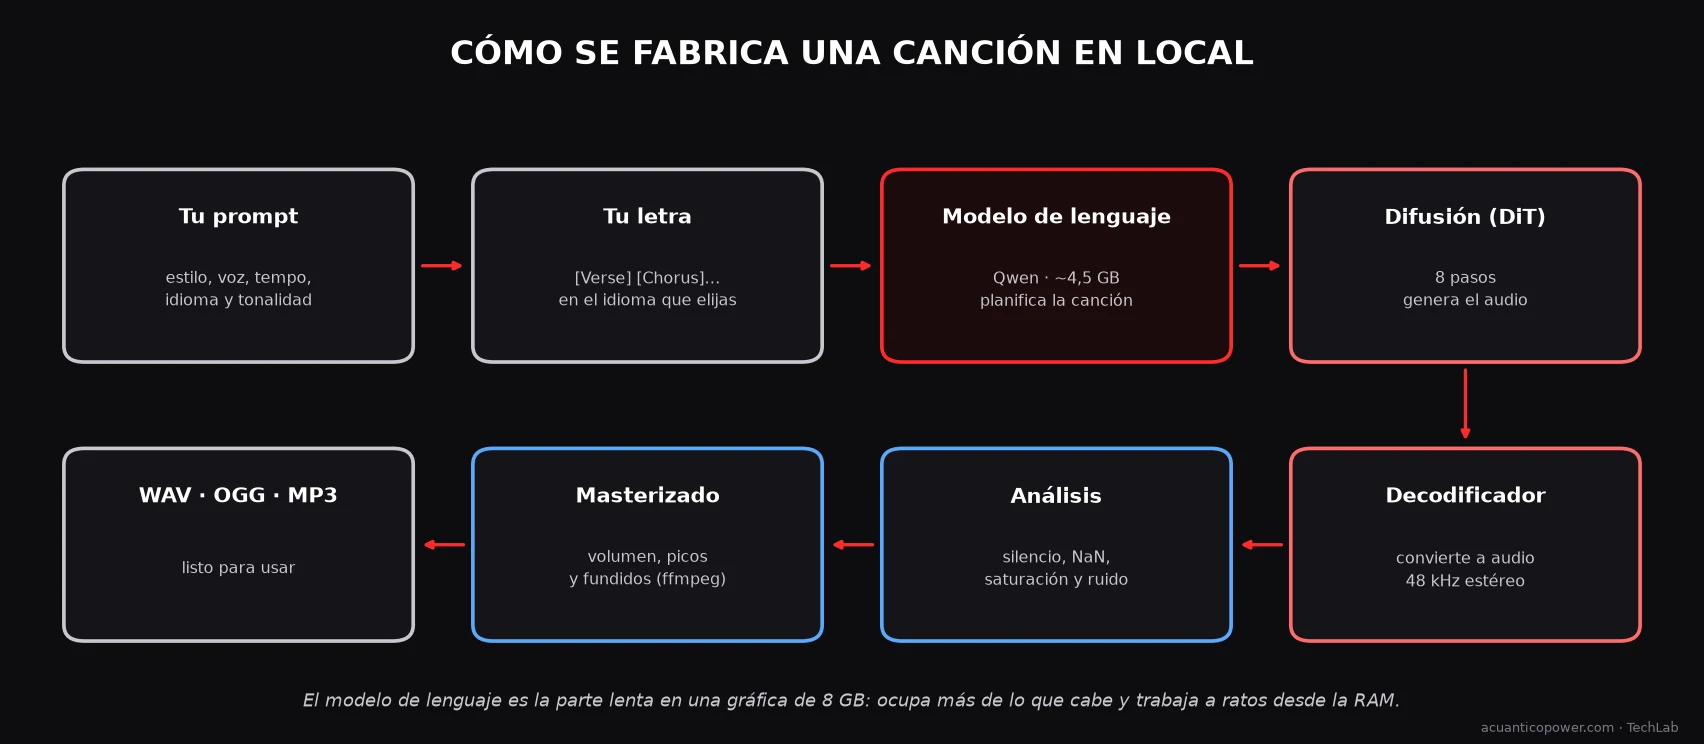
1. Tu descripción del estilo, en inglés: género, instrumentos, tipo de voz, tempo y ambiente. Más el BPM, la tonalidad, el compás y el idioma de la letra.
2. Tu letra, con marcas de estructura como [Verse 1], [Chorus] o [Outro].
3. El modelo de lenguaje lee las dos cosas y planifica la canción: cuántas partes tiene, cómo se reparten y qué «códigos de audio» le corresponden.
4. La difusión genera el audio, ya comprimido, en 8 pasos.
5. El decodificador lo convierte en sonido estéreo a 48 kHz. Lo he comprobado en el código del nodo de ComfyUI: el espacio de trabajo tiene 25 instantes por segundo de canción.
6. El análisis automático descarta generaciones rotas: silencio, valores no numéricos, saturación y ruido. Es una pieza mía.
7. El masterizado: volumen, picos y fundidos de entrada y salida con ffmpeg. También es mío.
8. El resultado se guarda en WAV, OGG o MP3.
Los parámetros de la plantilla oficial de ComfyUI para la 1.5 turbo, que son los que uso:
| Parámetro | Valor |
|---|---|
| Pasos de muestreo | 8 |
| CFG del muestreador | 1 |
| Muestreador y planificador | euler · simple |
| Desplazamiento (shift) | 3 |
| Compás | 4 |
| CFG, temperatura y top_p del modelo de lenguaje | 2,0 · 0,85 · 0,9 |
| Generar códigos de audio | Activado |
Sobre los números: son los de la plantilla que trae ComfyUI y no los he tocado en el experimento principal.
Se acabó la memoria
A la primera, nada. La canción no llegó a empezar a sonar: ComfyUI abortaba con un error de memoria dentro del propio nodo que lee la letra.
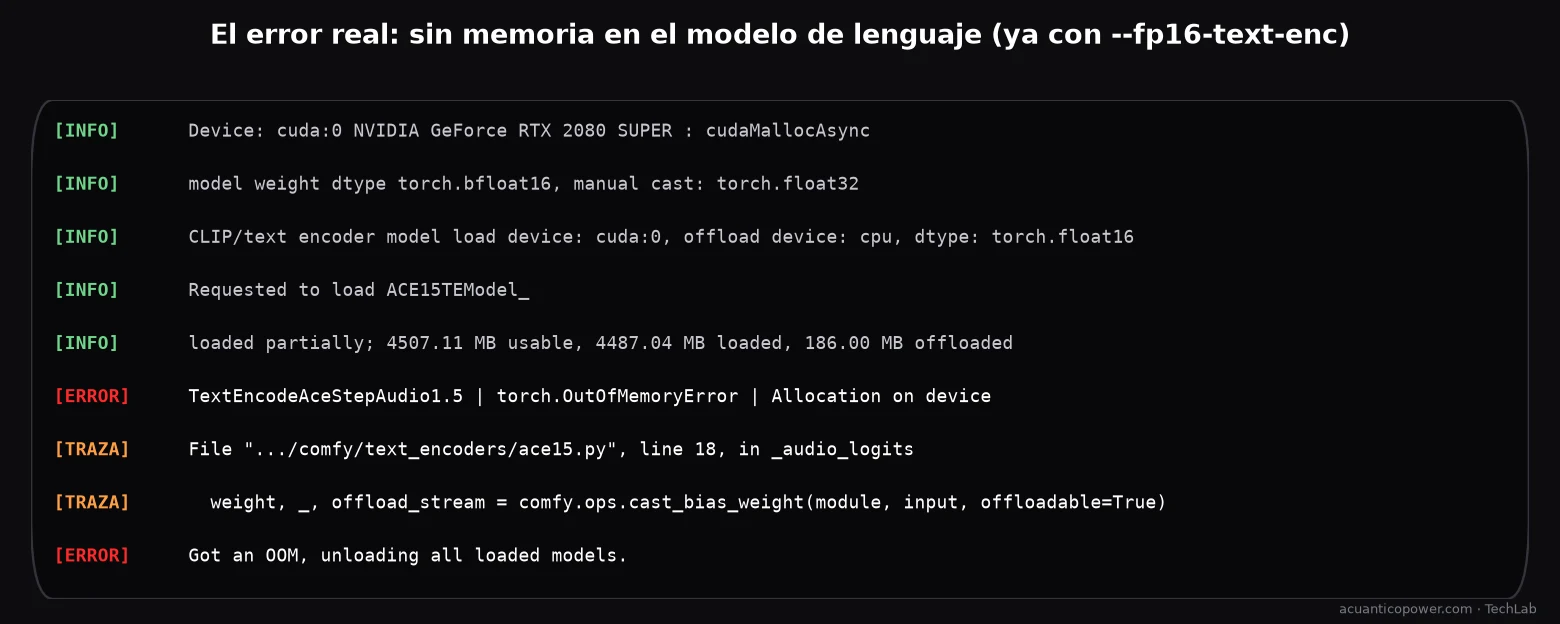
La causa tiene dos capas. La primera es la tarjeta: la 2080 SUPER es una Turing y no calcula en bf16, el formato en el que viene el modelo de difusión. El registro de ComfyUI lo dice con todas las letras: model weight dtype torch.bfloat16, manual cast: torch.float32. La segunda es mi propio escritorio: entre el panel de KDE, el compositor, el navegador y el editor hay casi 2 GB de la tarjeta ocupados antes de empezar.
Probé tres configuraciones de arranque:
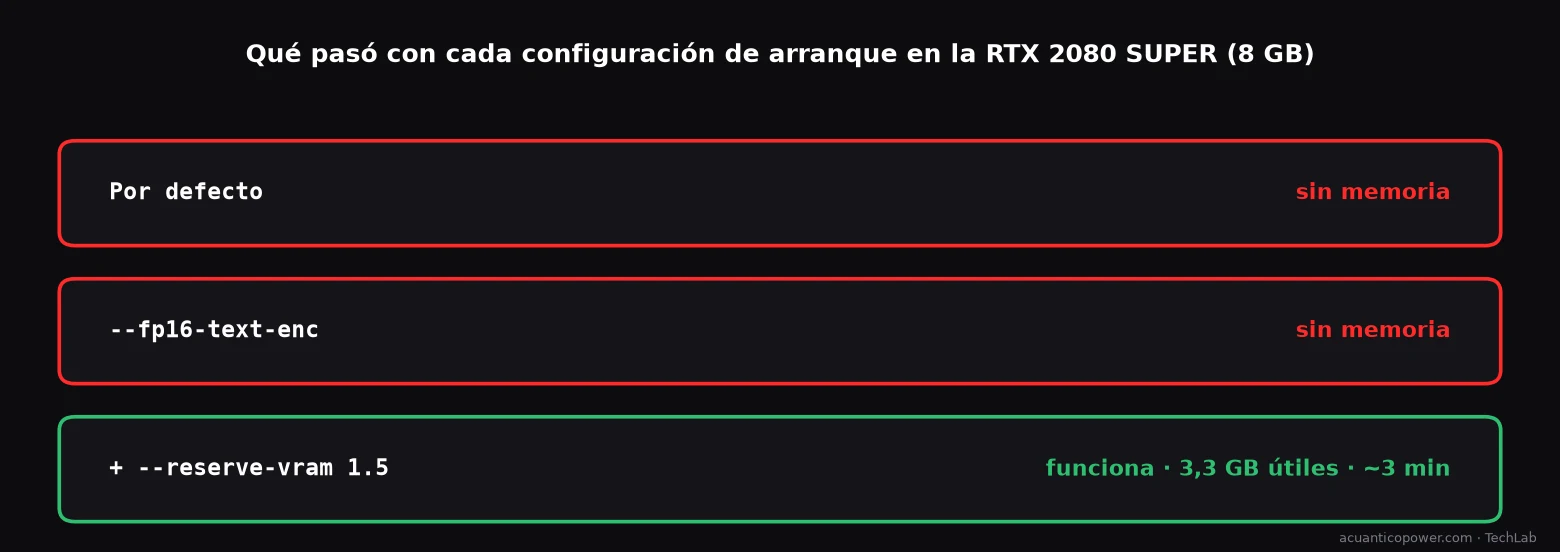
- Por defecto: sin memoria.
- Con
--fp16-text-enc: el modelo de lenguaje pasa a fp16 y ya cabe casi entero (4.487 MB cargados de 4.507 utilizables), pero no queda hueco para sus propios cálculos. Sin memoria igualmente. - Con
--fp16-text-enc --reserve-vram 1.5: se reservan 1,5 GB de margen. ComfyUI tiene 3,3 GB útiles, deja unos 1,3 GB del modelo en la RAM y el cálculo funciona.
Esa última es la buena. Cuesta tiempo, porque parte del modelo viaja de la RAM a la tarjeta y vuelta, pero funciona.
Cuánto tarda y qué pasa con la RAM
Medí cada generación de principio a fin, con el modelo ya en memoria:
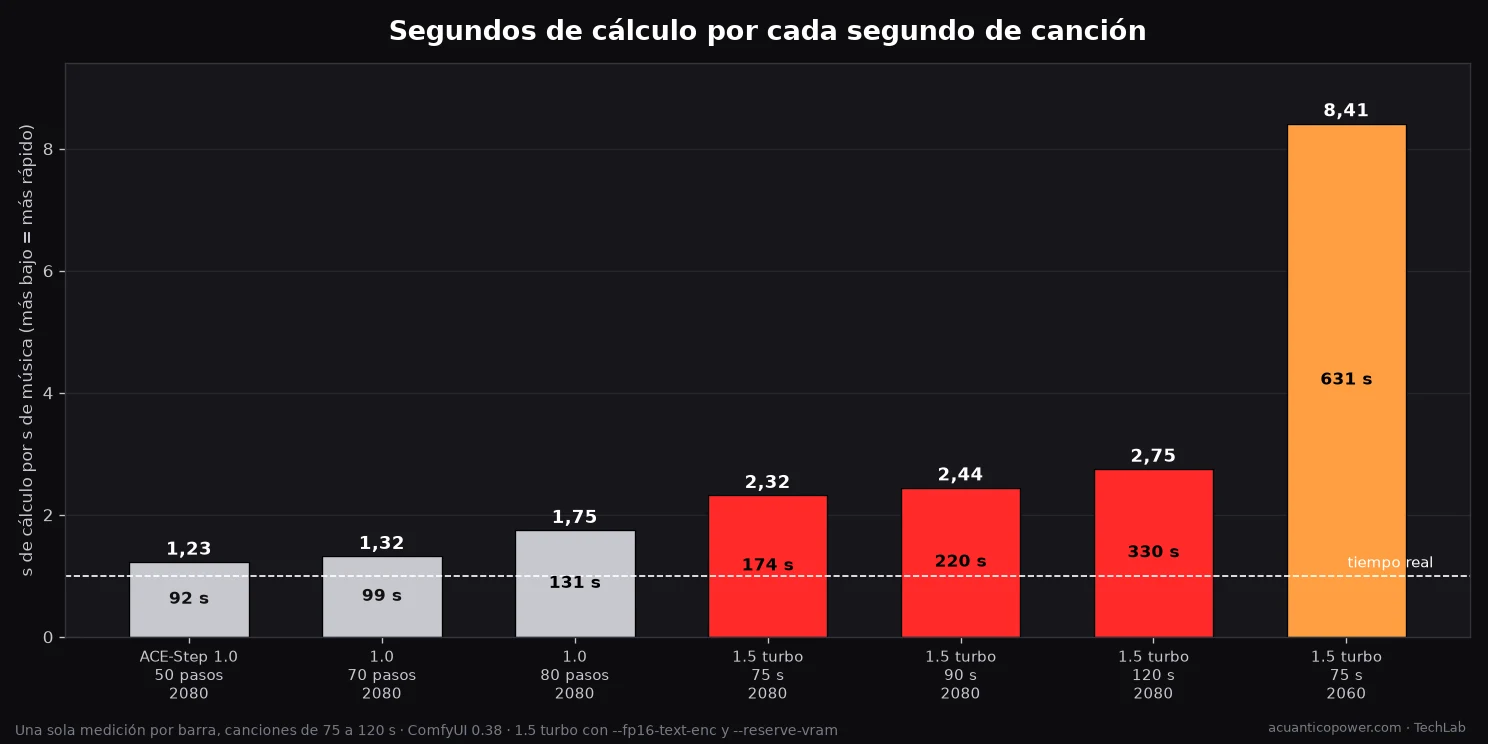
La 1.0 es más rápida. La 1.5 turbo necesita entre 2,3 y 2,8 segundos por cada segundo de música en la 2080, y el motivo es el modelo de lenguaje. Lo comprobé sin querer: en una ejecución ComfyUI reutilizó la planificación de una anterior y la canción de 75 s salió en 6 segundos. Es decir, los 8 pasos de difusión y el decodificador son rapidísimos; casi todo el tiempo, unos tres minutos, se va en planificar.
La RTX 2060 es el contraste. Con menos memoria, el modelo de lenguaje apenas cabe en la tarjeta y casi todo se hace desde la RAM. Una canción de 75 s tardó 631 s: 3,6 veces más que en la 2080. Probé con --reserve-vram 1.0 y se quedaba sin memoria; con 2.0 funcionó.
Y la RAM importa. ComfyUI llegó a ocupar 14,4 GB. En un momento cargué a la vez el modelo todo en uno y otro modelo de difusión de prueba, y el protector de recursos de Agente Jiménez, que vigila la RAM libre, detuvo ComfyUI al bajar de los 4 GB. Con 32 GB sobra, pero conviene no abrir nada pesado a la vez.
¿Se entiende lo que canta?
Cuando una IA canta, lo primero que falla suele ser la dicción. Quería medirlo con algo objetivo, así que monté una prueba con tres piezas:
- demucs separa la voz del resto de la canción.
- Whisper (faster-whisper, modelo large-v3) transcribe esa voz en español.
- Comparo la transcripción con la letra original, palabra a palabra.
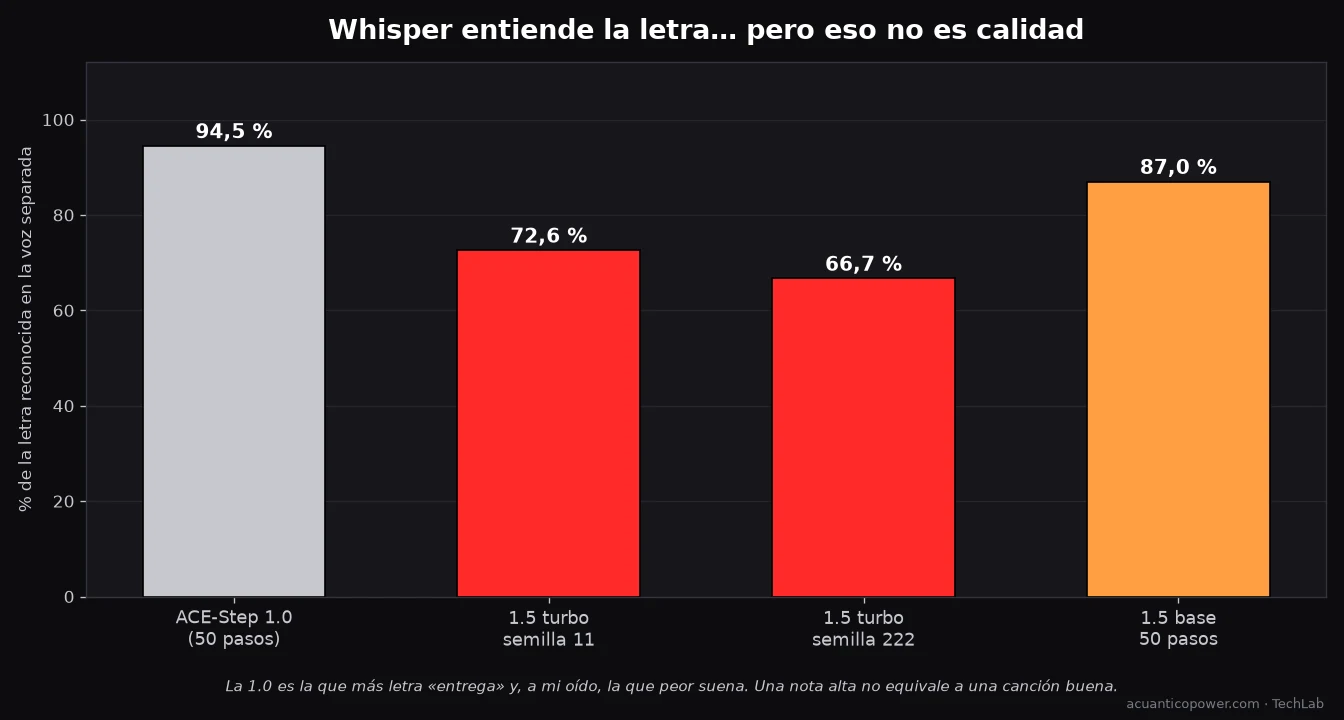
Y aquí aparece la sorpresa. La versión 1.0 es la que saca la nota más alta: Whisper reconoce el 94,5 % de la letra. Las dos canciones de la 1.5 turbo sacan 72,6 % y 66,7 %, y la 1.5 base con 50 pasos, 87 %.
Y, aun así, la que más me convence a mí es una de la 1.5 turbo. La 1.0 pronuncia casi todo, pero a mi oído suena peor. La nota de Whisper mide dicción. No mide la calidad del sonido, ni la naturalidad de la voz, ni cómo se integra con la música.
Moraleja que me llevo: una métrica automática sirve para descartar lo roto, no para elegir lo bueno. Para elegir sigue haciendo falta un oído.
Dos cautelas sobre estos números. Son una canción por modelo y una semilla por canción, no una estadística. Y Whisper tiende a «completar» frases conocidas, así que puede dar por buena una letra que se ha cantado peor de lo que parece.
Dos canciones con la misma letra
Escucha tú mismo la diferencia. Es la misma letra, el mismo estilo y la misma duración, 75 s, masterizadas con el mismo tratamiento:
Diez canciones, diez voces
Una canción no dice mucho. Así que pedí diez, todas de 30 segundos: cinco en inglés y cinco en español, con voces y géneros distintos. Mismo método para todas: ACE-Step 1.5 turbo, 8 pasos, una semilla por canción (en dos casos tuve que cambiarla, lo cuento abajo), letras mías cortas (una estrofa y un estribillo) y el masterizado de dos pasadas del apartado siguiente. Cada una tardó entre 90 y 150 segundos desde que pulsé el botón hasta tener el archivo terminado (mediana: 105 s), incluyendo el modelo de lenguaje, el audio y el masterizado.
Dale al play. Debajo de cada una te dejo la descripción exacta de estilo que envié al modelo.
Rock alternativo · voz masculina rasgada
Synthwave ochentero · voz masculina suave
Jazz de salón · voz femenina aterciopelada
Eurodance de los 90 · voz femenina
Power metal · voz masculina agresiva
Balada pop · voz femenina cálida
Flamenco pop · voz femenina con fuerza
Trap español · rap masculino
Folk acústico · voz masculina grave
Reggaetón · voz femenina
| Muestra | Idioma | bpm | Tiempo hasta terminar | Letra reconocida (Whisper) |
|---|---|---|---|---|
| Rock alternativo · voz masculina rasgada | inglés | 128 | 150 s | 96,0 % |
| Synthwave ochentero · voz masculina suave | inglés | 100 | 110 s | 61,5 % |
| Jazz de salón · voz femenina aterciopelada | inglés | 88 | 110 s | 66,7 % |
| Eurodance de los 90 · voz femenina | inglés | 135 | 120 s | 95,7 % |
| Power metal · voz masculina agresiva | inglés | 165 | 140 s | 30,4 % |
| Balada pop · voz femenina cálida | español | 72 | 100 s | 79,3 % |
| Flamenco pop · voz femenina con fuerza | español | 104 | 90 s | 55,8 % |
| Trap español · rap masculino | español | 140 | 100 s | 38,1 % |
| Folk acústico · voz masculina grave | español | 84 | 100 s | 44,4 % |
| Reggaetón · voz femenina | español | 96 | 100 s | 72,3 % |
La tabla enseña algo. Al revisar yo las diez, el synthwave y el eurodance salieron con una letra que no se entendía con mis primeras semillas: la voz estaba (su volumen era parecido al del tema de rock), pero no se distinguían palabras, y Whisper lo confirma con un 0 % en las dos. Las regeneré con otras semillas. El synthwave necesitó cuatro intentos más (36,4 %, 0,0 %, 61,5 %, 37,8 %, por orden) y el eurodance dos (95,7 %, 85,1 %). Me quedé con el mejor de cada uno. La métrica solo me sirvió para confirmar lo que había oído, y repito la advertencia de antes: no dice cuál suena mejor.
Otra cautela: Whisper suele añadir un «Gracias por ver el vídeo» o un «Thank you» al final del audio, y eso resta puntos. Cifras bajas como el 30,4 % del power metal (la transcripción se queda en bucle en una línea) o el 38,1 % del trap (rap, con autotune) no significan que la letra se pierda, solo que a la métrica le costó seguirla.
El audio crudo no se puede usar tal cual
Lo que sale de ACE-Step no está listo para publicar. Lo medí con el estándar de volumen de la radio y la televisión (EBU R128):
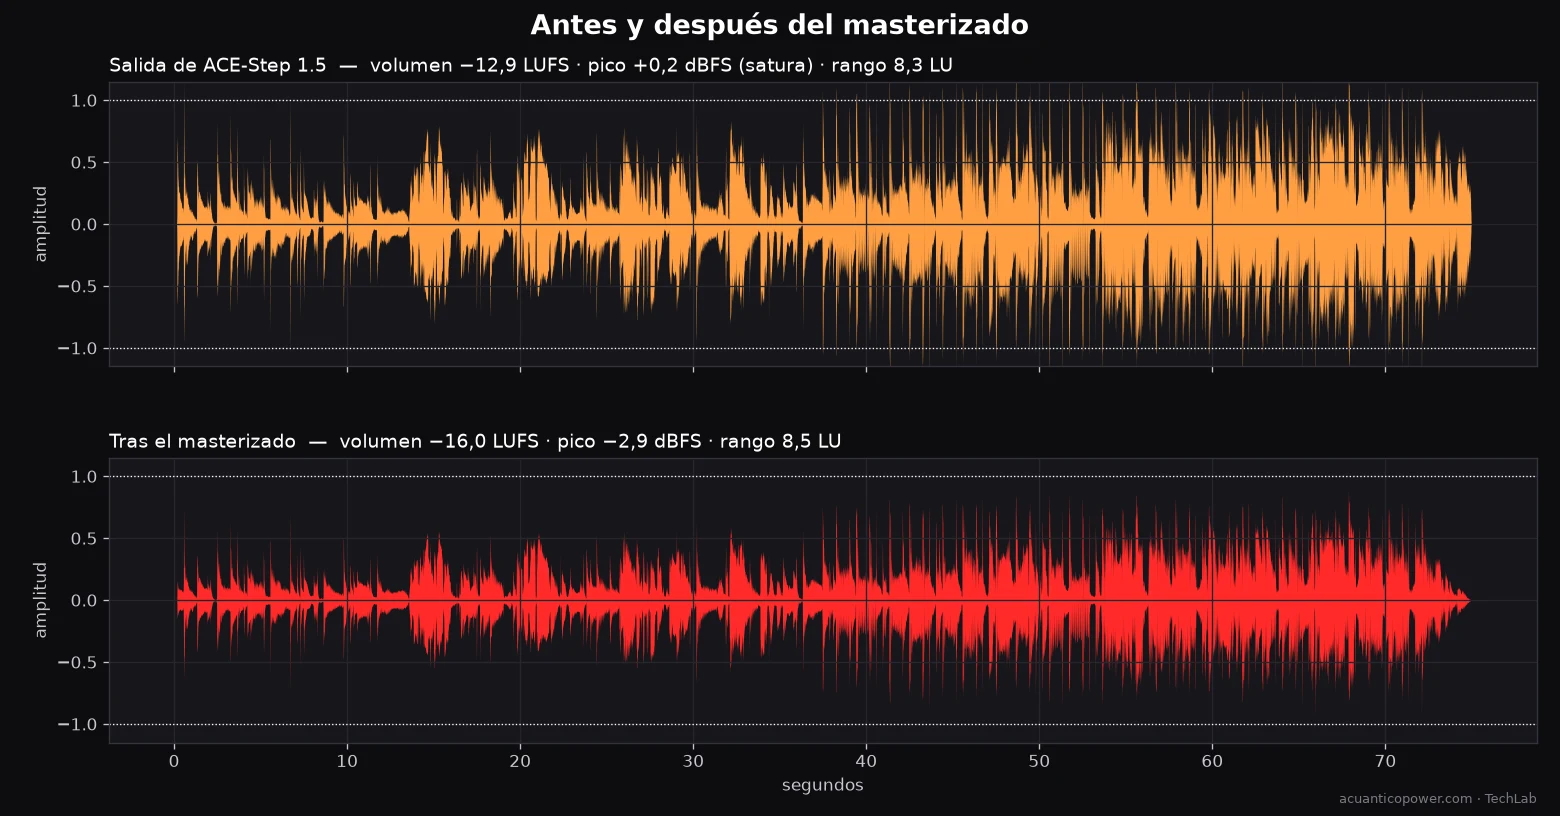
- El audio crudo: −12,9 LUFS de volumen integrado y un pico verdadero de +0,2 dBFS, es decir, por encima del máximo digital.
- Masterizado de una pasada (mi primera versión): −14,0 LUFS, pico de −1,3 dBFS y el rango dinámico aplastado de 8,3 a 4,7 LU. Pedí −16 LUFS y salieron −14,0.
- Masterizado en dos pasadas: −16,0 LUFS exactos, pico de −2,9 dBFS y rango de 8,5 LU. Primero mido la canción con
loudnormde ffmpeg y después aplico una ganancia lineal con esas medidas, más límite de picos y fundidos de entrada y de salida.
La diferencia importa. El filtro de una pasada aplastaba la diferencia entre las partes suaves y las fuertes; el de dos pasadas solo sube o baja el volumen de toda la canción por igual y respeta su contraste. Para una canción plana no importa. Para una que sube y explota, sí. Adolfo-BPM usa ya la versión de dos pasadas; la medida es de una sola canción (75 s), no una estadística.
¿Hace una intro suave que sube y explota?
Mi prueba final fue la más exigente. Quería una canción de música máquina, hardcore, de principios de los 2000, de las que se conocían como cantaditas, con voz femenina en inglés, que empezara suave, con una melodía que te pusiera la piel de gallina, subiera rápido y explotara. Y con el nombre de mi web en el estribillo.
Para saber si el modelo hace lo que pido sin fiarme de mis oídos, medí la energía de la canción segundo a segundo y dibujé su espectrograma:
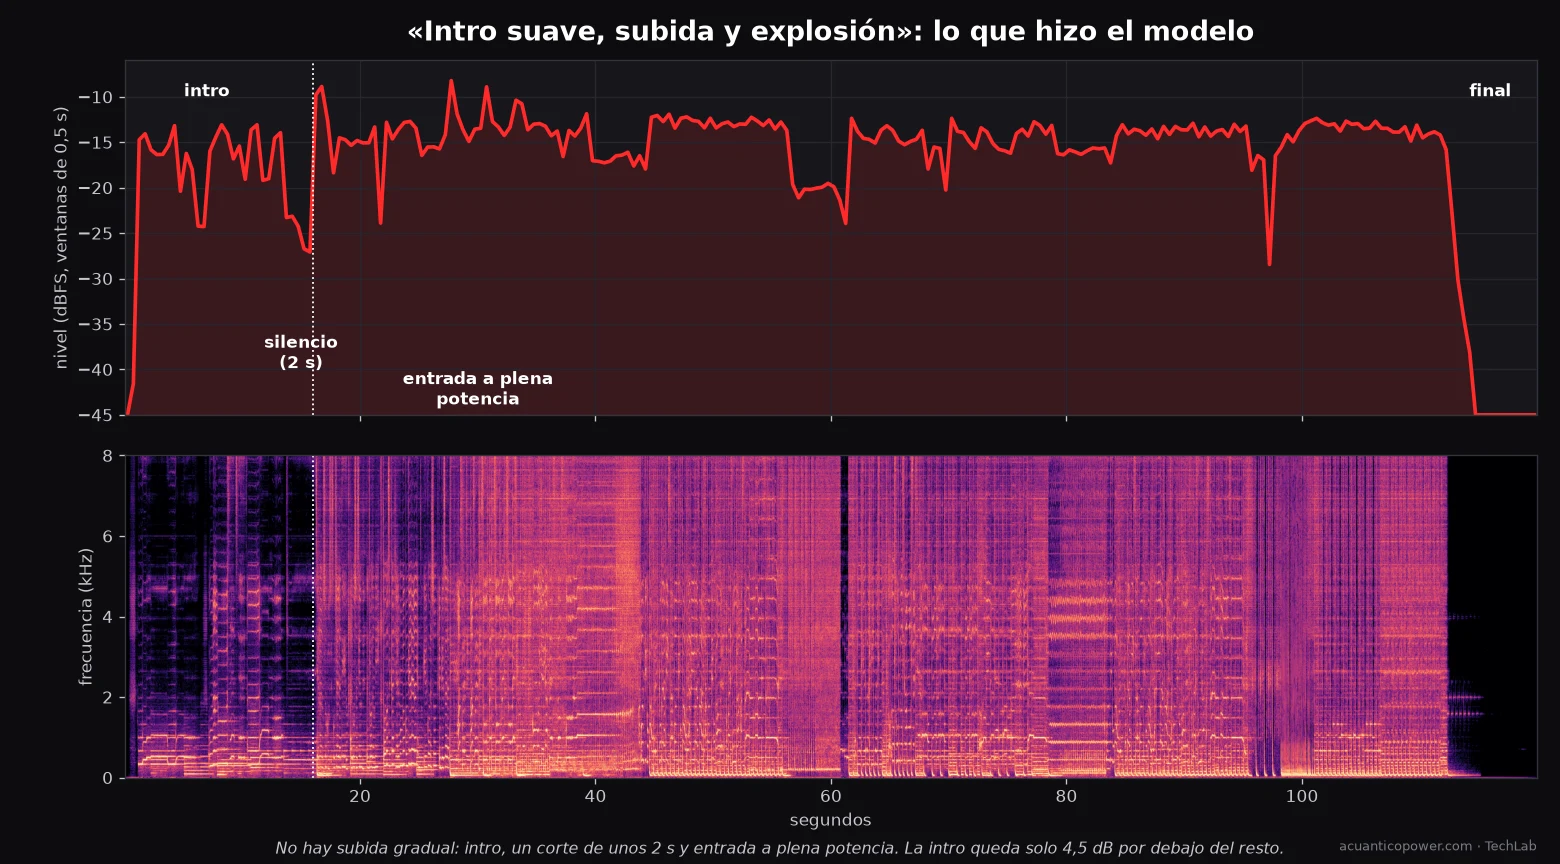
El modelo hace una estructura reconocible: una intro de unos 14 segundos, un silencio de 2 segundos, y a los 16 s entra a plena potencia. Es un recurso típico de la música de baile. Pero no hay una subida gradual, y la intro queda solo 4,5 dB por debajo del resto. Estas dos canciones se masterizaron todavía con la versión de una pasada, que, como vimos, reducía ese contraste; la medida de 4,5 dB incluye ese efecto.
Lo que me llevo: ACE-Step 1.5 entiende «intro, silencio, explosión», pero no «sube poco a poco». Para conseguir un crescendo de verdad habría que construirlo por partes y montarlo a mano.
La vista de Adolfo-BPM
Todo esto lo hago desde una vista propia en Agente Jiménez. Estas son las capturas reales de la interfaz:
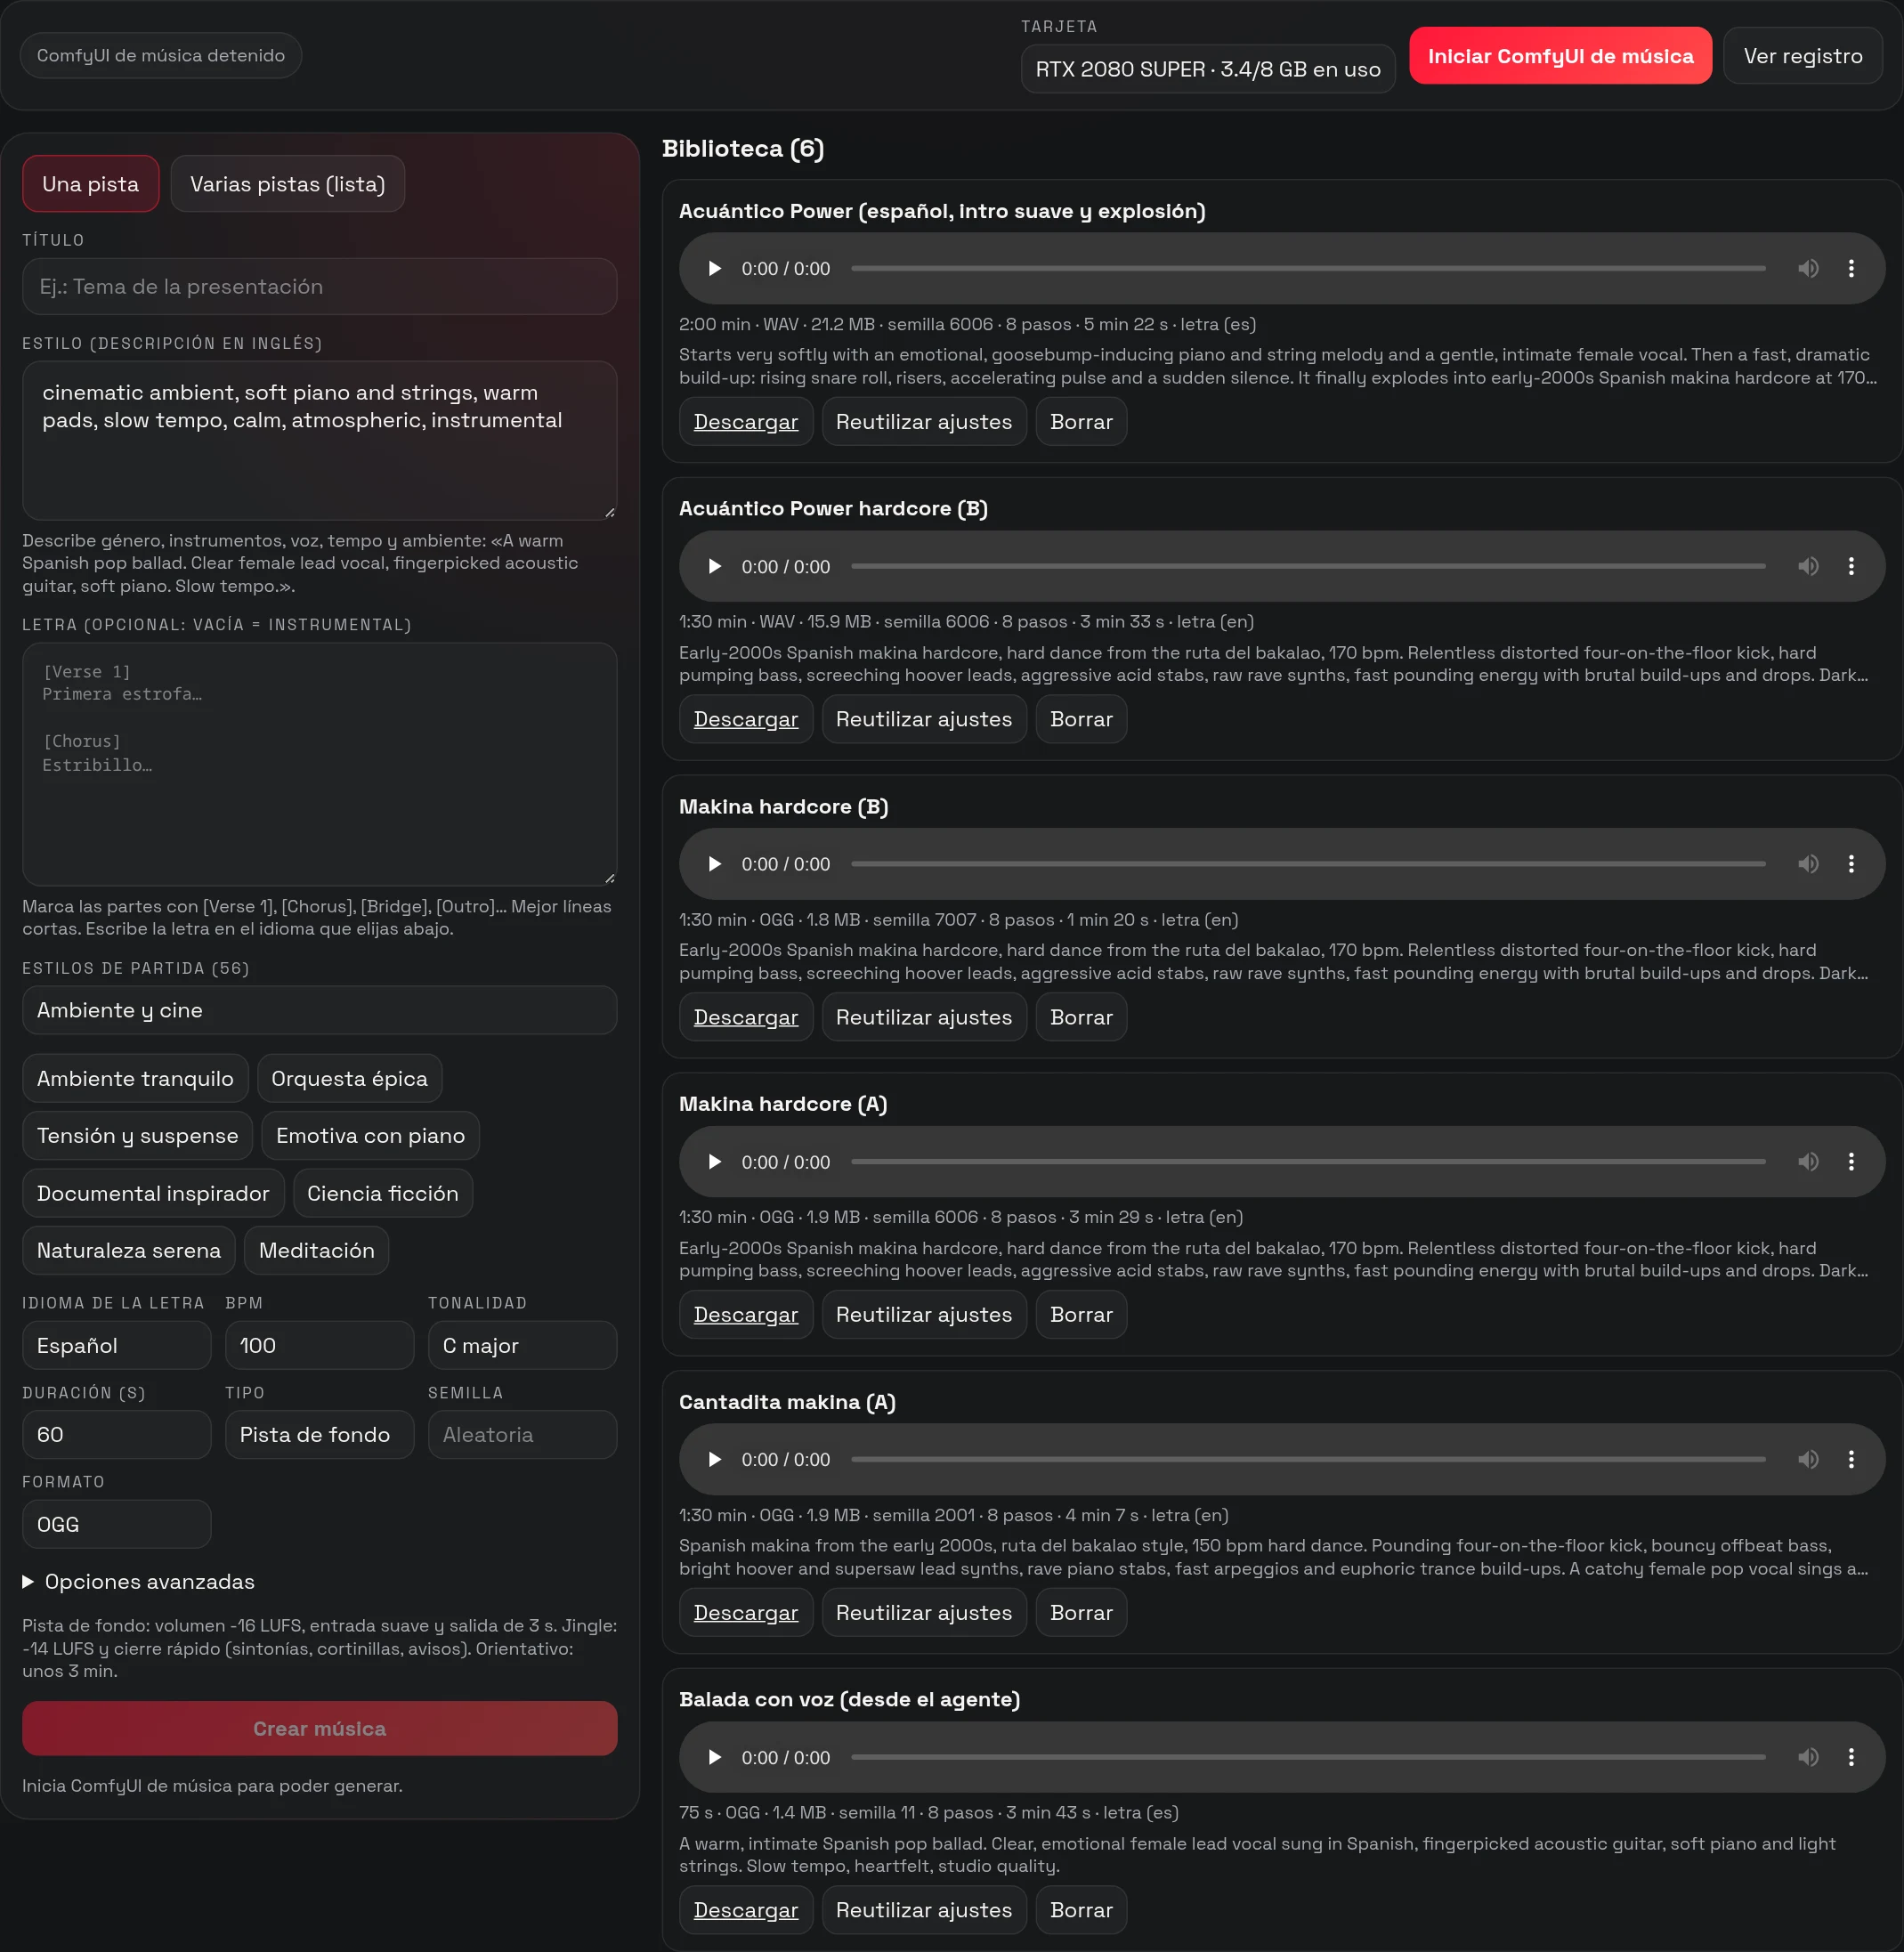
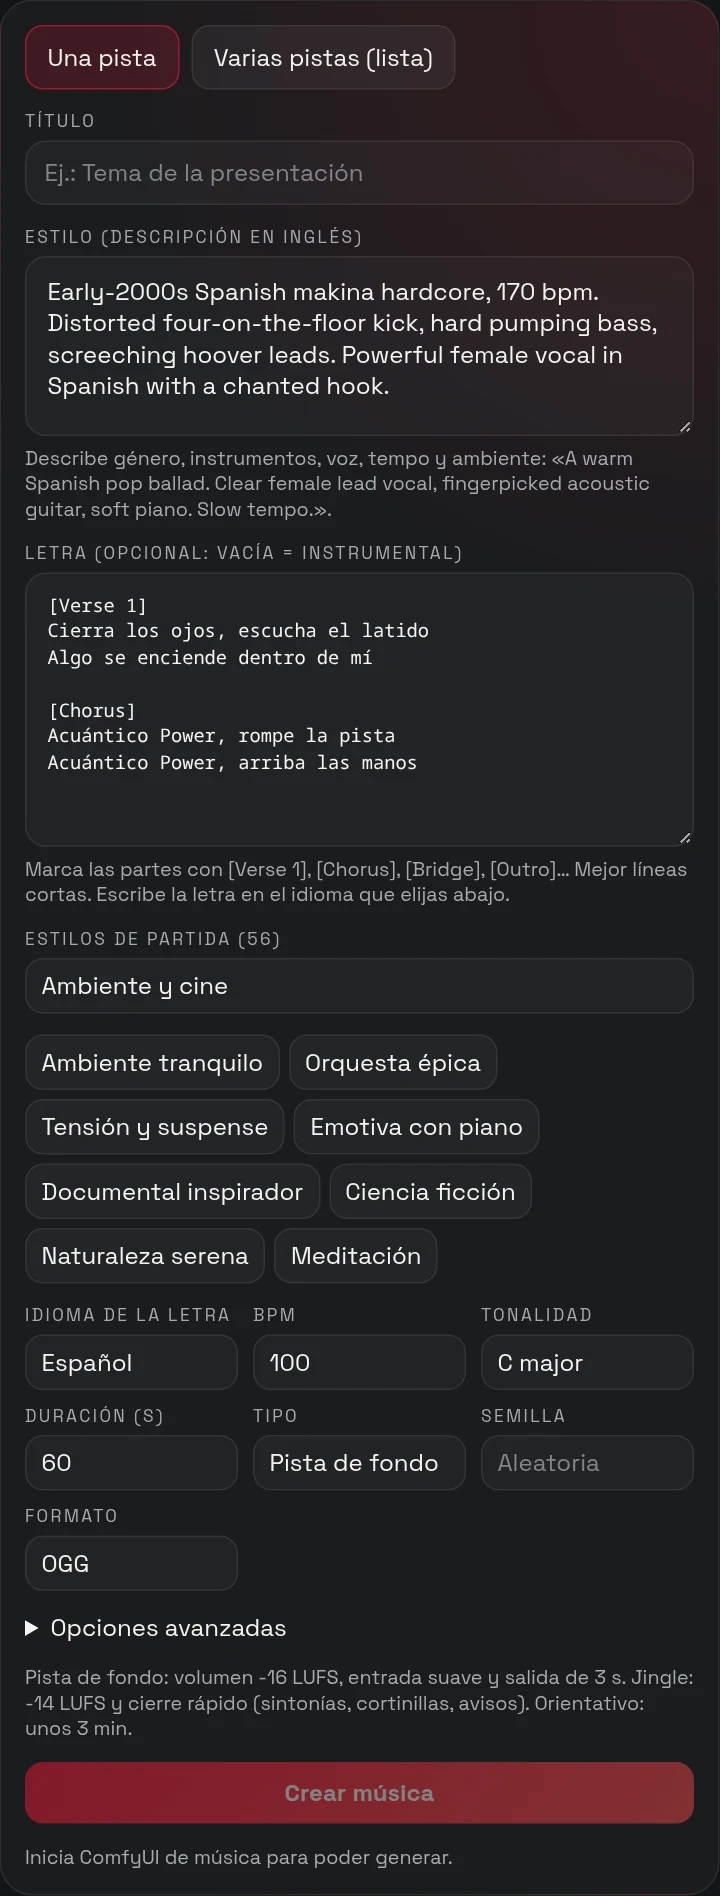
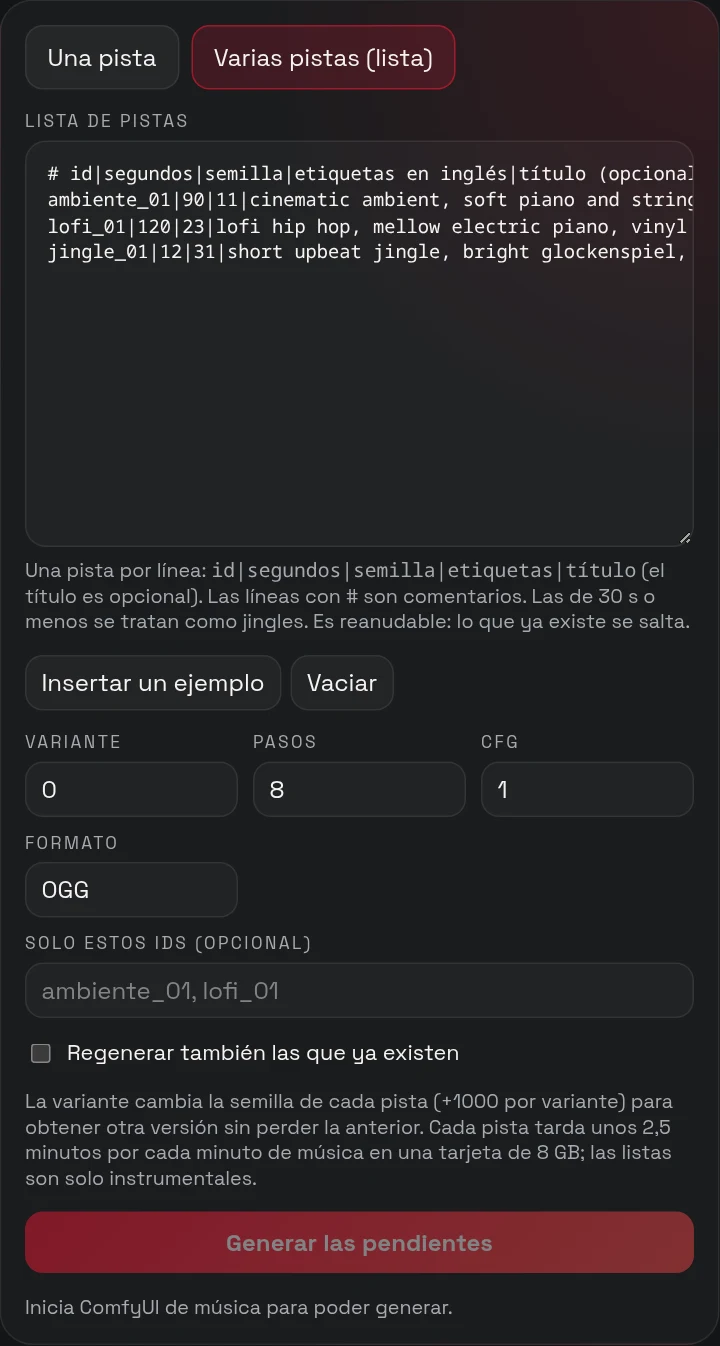
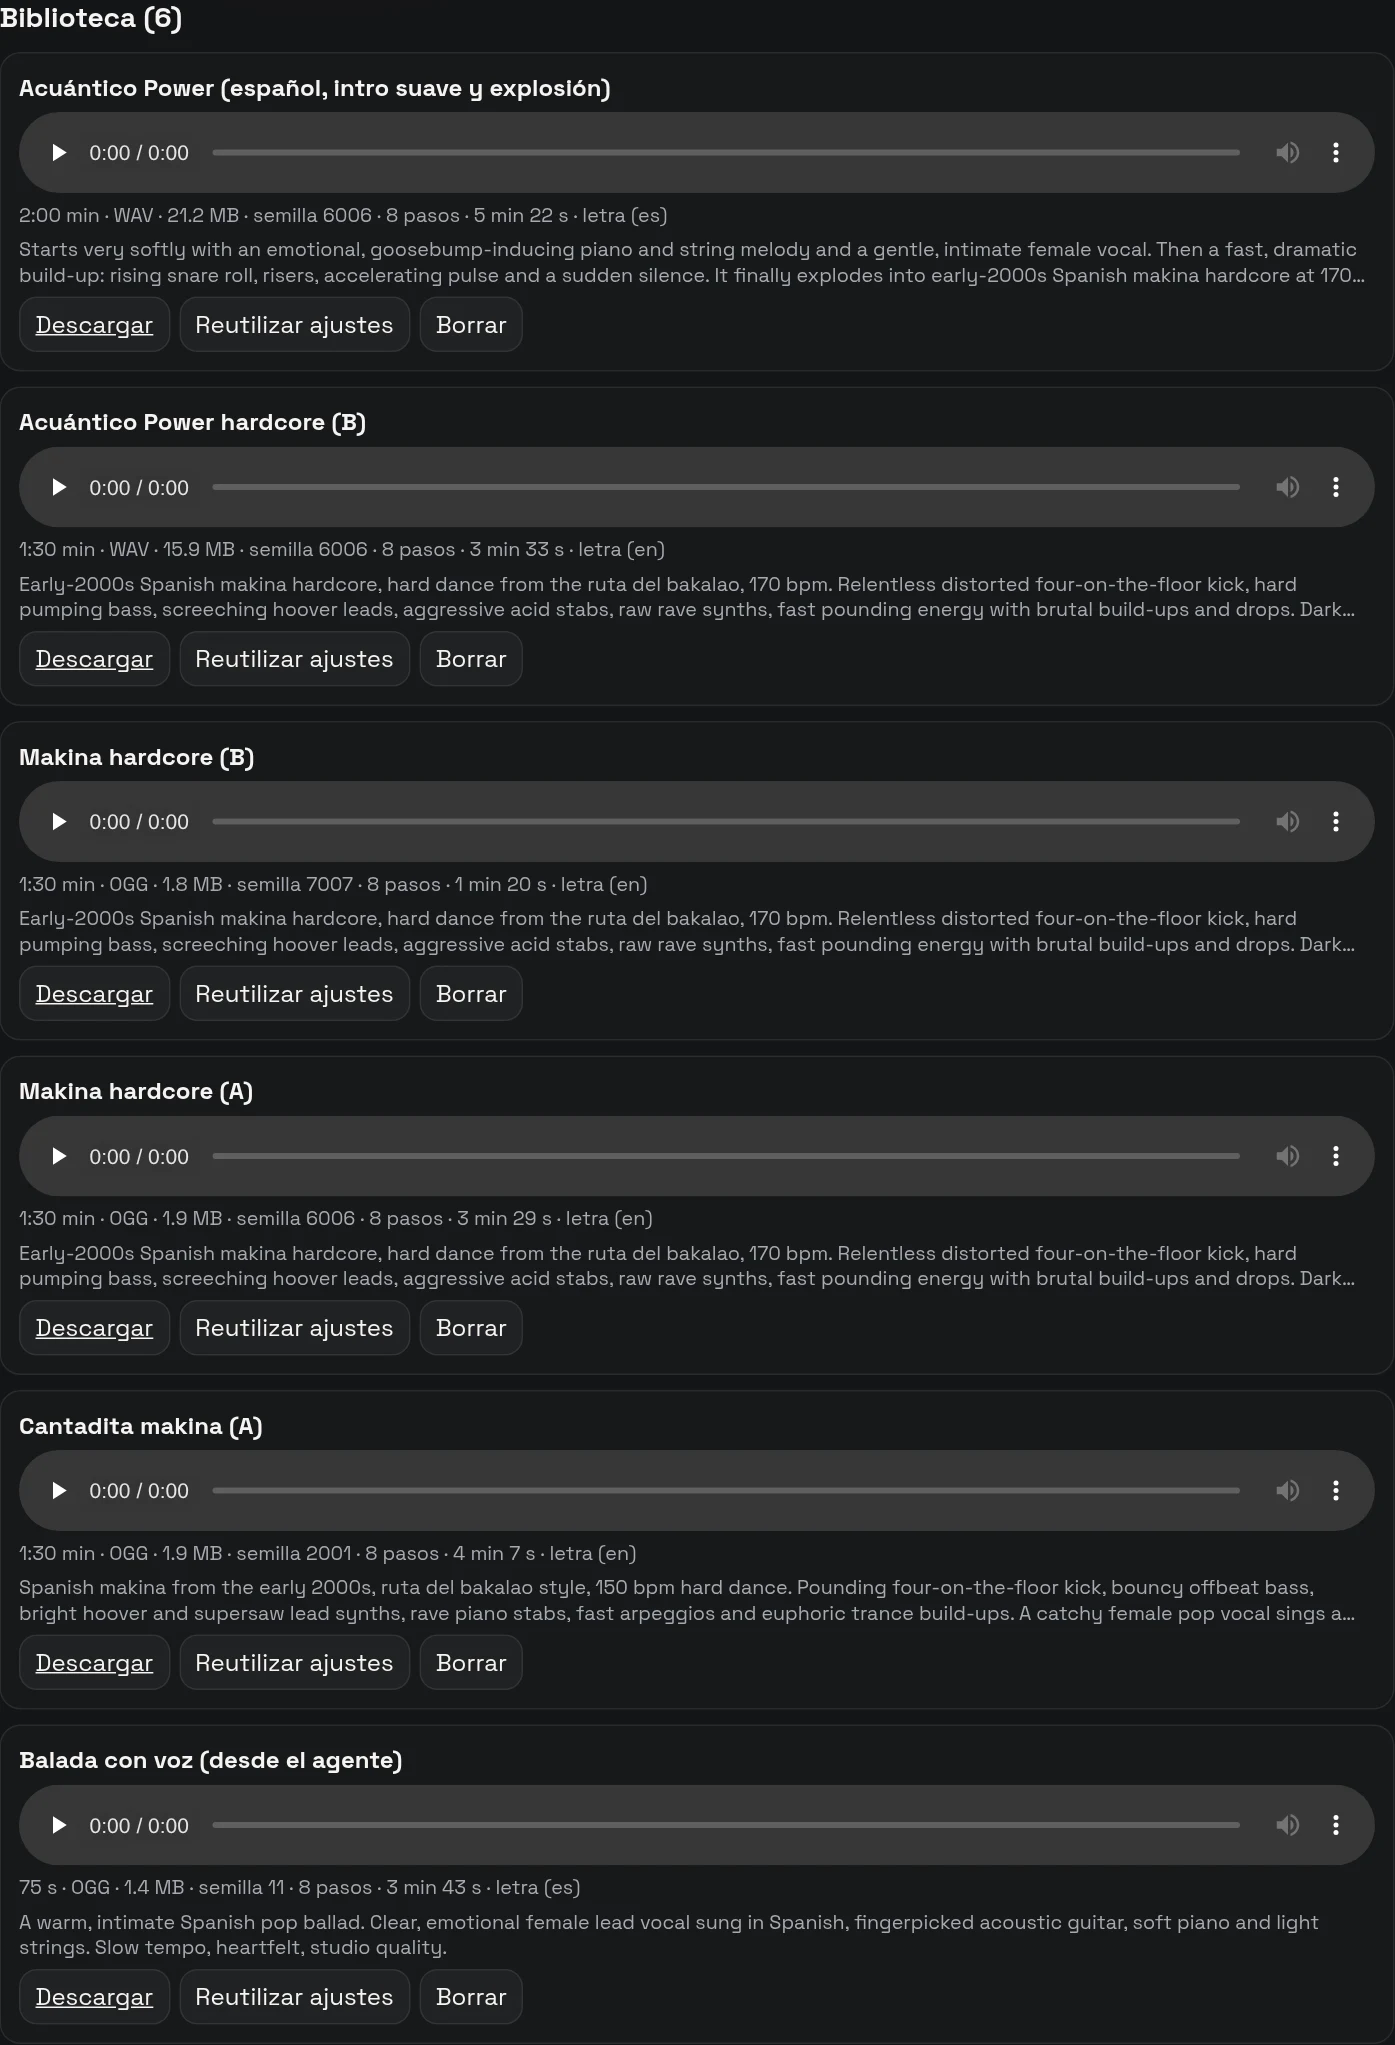
Hay 56 estilos de partida en 7 familias, desde ambiente y cine hasta electrónica, jazz o jingles. Rellenan la descripción, el BPM y la duración, y se pueden editar después.
Cómo hacer música con IA local en tu equipo
Todo lo que necesitas es una gráfica NVIDIA y ComfyUI. Estos son los pasos que he seguido:
1. Actualiza ComfyUI a una versión que incluya los nodos de ACE-Step 1.5. Yo uso la 0.38.
2. Descarga el modelo. El fichero es ace_step_1.5_turbo_aio.safetensors (10 GB, licencia Apache-2.0), del repositorio Comfy-Org/ace_step_1.5_ComfyUI_files de Hugging Face. Va en la carpeta de checkpoints de ComfyUI.
3. Arranca ComfyUI con margen de memoria si tu tarjeta tiene 8 GB: python main.py --fp16-text-enc --reserve-vram 1.5 --disable-pinned-memory. Con 12 GB o más no hace falta.
4. Abre la plantilla oficial «ACE-Step 1.5 Music Generation AIO» en la biblioteca de plantillas de ComfyUI (apartado Audio).
5. Escribe el estilo y la letra. En el nodo de texto verás los campos de etiquetas, letra, BPM, duración, compás, idioma y tonalidad.
6. Genera y espera. Una canción de 75 s tarda unos 3 minutos en una tarjeta de 8 GB.
7. Masteriza el resultado: normaliza el volumen y limita los picos.
Los consejos que me hubiera gustado tener:
- Pide la letra en el idioma que quieres oír. El selector de idioma del nodo existe: úsalo.
- Marca la estructura con [Verse 1], [Chorus], [Outro]. Cuanto más clara la estructura, mejor la sigue.
- Líneas cortas. Cuanto más largas, peor las canta.
- Los nombres propios raros, escritos tal cual, se pronuncian mal. Escríbelos en fonética.
- Prueba varias semillas. Con una sola no sabes si te ha tocado una buena o una mala.
Qué no he medido
- Solo una tarjeta de cada tipo. Los tiempos de una RTX 2080 SUPER y una RTX 2060 no se pueden extrapolar a otras.
- Una canción y una semilla por configuración. No tengo estadística: son observaciones, no conclusiones.
- El modelo «base» de la 1.5. Lo probé con 50 pasos una sola vez; no es una comparación seria.
- Los modelos XL y el modelo de lenguaje de 4.000 millones (8,4 GB), que existen pero no caben en mi equipo.
- El oído de otras personas. Mi valoración de cómo suena es mía.
Qué me llevo de hacer música con IA local
La música con IA local, con voz y letra, es posible en una gráfica de 8 GB. No es rápida, no es perfecta y no es gratis en términos de RAM: tarda unos tres minutos por cada minuto de música y necesita unos ajustes que no vienen por defecto. Pero funciona sin enviar una sola letra a nadie, sin suscripción y sin límite de canciones.
Lo que más me ha sorprendido es que una gráfica de 2019 cante en español y en inglés, y en estilos tan distintos como un flamenco pop y un power metal. Y que el trabajo no está en generar la canción, sino en revisarla: de diez, dos las tuve que repetir.
Si te ha servido, invítame a un café
Todo lo de este artículo lo he hecho en una gráfica de 2019, sin nube y sin suscripciones. Lo único que no sé generar en local es el café.
Así que le pedí al flujo de este mismo artículo una última canción: cuatro minutos, en reggaetón, con una letra para pedirte un cafecito. Cuatro minutos es lo máximo que admite Adolfo-BPM, y en 8 GB solo me cabían arrancando ComfyUI con --use-split-cross-attention además de los ajustes anteriores: sin él se quedó sin memoria con 180 y con 240 segundos. Tardó unos 9 minutos y medio y Whisper reconoce el 81 % de la letra (voz separada con demucs), una cifra que como siempre solo dice si se entiende, no si suena bien.
¿Te ha gustado? Invítame a un café
Cuatro minutos de reggaetón, con letra para pedirte un cafecito, hechos en local en una RTX 2080 SUPER de 8 GB.
- 4:00
- Reggaetón
- Voz y letra con IA
- 100 % local
Ver la letra
[Intro]
Ey, Acuántico Power
Atención, esto es una emergencia
Cafecito, cafecito
[Verse 1]
Mi gráfica es del diecinueve y aún le sobra talento
Compone toda la noche sin pedirme un aumento
Sin nube, sin suscripción, no te cobro ni un euro
Pero el café de las mañanas, ay, eso sí que lo echo de menos
[Pre-Chorus]
Yo pongo la música
Tú pones la cafeína
Y juntos, mi gente, rompemos la rutina
[Chorus]
Págame un cafecito, un cafecito en Kofi
Un clic y soy feliz, un clic y soy feliz
Que sin cafeína no arranco, no suelto ni una rima
Cafecito, cafecito, ponme un cafecito encima
[Verse 2]
Mi ventilador se queja, mi gato duerme en la torre
Mi factura de la luz llora cada vez que el modelo corre
Mil pruebas por una estrofa que por fin salió redonda
Y si te gusta, amigo, ahora te toca la ronda
[Pre-Chorus]
Yo pongo la música
Tú pones la cafeína
Y juntos, mi gente, rompemos la rutina
[Chorus]
Págame un cafecito, un cafecito en Kofi
Un clic y soy feliz, un clic y soy feliz
Que sin cafeína no arranco, no suelto ni una rima
Cafecito, cafecito, ponme un cafecito encima
[Verse 3]
Un cafecito son dos canciones y media sin parar
Una idea nueva en marcha y otro sueño por probar
Tú pones el café, yo pongo las noches enteras
Y entre los dos, mi gente, esto no hay quien lo pare
[Bridge]
Y si hoy no puedes, no pasa nada, de verdad
Comparte el artículo, que también es ayudar
Y tú, que me escuchas, no esperes a mañana
Crea lo tuyo, que con una gráfica vieja y ganas se arma
[Chorus]
Págame un cafecito, un cafecito en Kofi
Un clic y soy feliz, un clic y soy feliz
Que sin cafeína no arranco, no suelto ni una rima
Cafecito, cafecito, ponme un cafecito encima
[Chorus]
Cafecito, cafecito, un cafecito en Kofi
Un clic y soy feliz, un clic y soy feliz
Cafecito, cafecito, ponme un cafecito encima
[Outro]
Gracias, gracias, gracias, mi gente
Búscame en Kofi, Acuántico Power
Cafecito, cafecito
Un café sostiene el proyecto: más pruebas, más medidas y más artículos como este.
Sigue explorando la IA local
- Un videojuego de cartas hecho con IA local, donde la música de ACE-Step 1.0 hace de banda sonora.
- Clonar tu voz en local con 8 GB, el otro lado de la voz con IA.
- TRELLIS 2 en 8 GB, otra prueba de hasta dónde llega una tarjeta de 2019.
- Programación autónoma con IA local.
- IA local frente a la nube: privacidad, potencia y límites reales.
Preguntas frecuentes
¿Se puede hacer música con IA local, con voz y letra, en una gráfica de 8 GB?
Sí. En mi RTX 2080 SUPER funciona ACE-Step 1.5 turbo en ComfyUI, pero hay que arrancarlo con --fp16-text-enc y --reserve-vram 1.5: sin esos ajustes el modelo de lenguaje se queda sin memoria.
¿Cuánto tarda en crear una canción?
En mi equipo, entre 2,3 y 2,8 segundos de cálculo por cada segundo de canción: unos 3 minutos para una de 75 s. Las muestras de 30 s tardaron entre 90 y 150 s en estar terminadas. En una RTX 2060 de 6 GB, 631 s para una de 75 s.
¿Mi letra sale de mi ordenador?
No. La generación corre en tu equipo, con ComfyUI; los modelos se descargan una sola vez.
¿Puede cantar en español?
Sí. Hay un selector de idioma y la letra se escribe en ese idioma. Marca la estructura con [Verse] y [Chorus], usa líneas cortas y escribe en fonética los nombres propios raros para que los pronuncie bien.
¿Cómo sé si la letra se entiende?
Escuchándola. Como apoyo, separé la voz con demucs y la transcribí con Whisper: sirve para descartar lo roto (dos de mis diez muestras salieron con 0 % de letra reconocida), pero no para decidir cuál suena mejor.
¿Qué volumen debo dejar a las canciones?
Yo las dejo en −16 LUFS con un masterizado de dos pasadas con loudnorm de ffmpeg, que conserva el contraste entre las partes suaves y las fuertes.