Caché de expertos en llama.cpp: ¿merece la pena en una RTX 2080 SUPER + 2060?
Ayer, mientras tomaba el primer café de la mañana, vi un vídeo de AlehandoroVR que hablaba de Strata.
Las ganas de probar Strata, o mejor dicho las ansias, fueron inmediatas.
Dediqué un rato de la tarde y parte de la noche a instalarlo y probarlo.
Su concepto es fantástico. Strata ejecuta modelos enormes en tarjetas gráficas pequeñas. Esos modelos son de tipo MoE: para cada palabra que escriben no consultan a todos sus «expertos», solo a unos pocos. Strata deja en la memoria de la tarjeta los expertos que más se usan, guarda el resto en la RAM y en el disco, y trae los que faltan solo cuando hacen falta. Es lo que se llama caché de expertos. Sobre el papel, un modelo de más de 100.000 millones de parámetros funcionando en una gráfica de 8 GB. Más abajo te lo explico con una analogía.
No os voy a mentir: lo probé vagamente y no conseguí buenos resultados. El razonamiento se comía todo el presupuesto de tokens y no llegaba a escribir ni una sola línea de código. Tan rápido como me ilusioné con el vídeo, me desilusioné al probarlo.
No le di muchas oportunidades, y un autorreflejo de mi dedo me llevó a desinstalarlo.
Pero me quedaron muchas ganas de probar la caché de expertos de llama.cpp, que hacía días que quería probar. Y esta es mi experiencia…
Este artículo es la continuación de mi primer artículo, Programación autónoma con IA local: ¿bastan 8 GB de VRAM?. Allí explico el hardware, qué es un agente de programación y cómo se mide, y cómo se comportaron Gemma 4, Cyber-Tiel y GLM-4.7-Flash. Aquí no repito todo ese contexto. Si no lo has leído, empieza por ahí y vuelve después.
Resumen de resultados
| Pregunta | Respuesta medida |
|---|---|
¿Ayuda la caché de expertos (--moe-cache-mib)? | No. Fue más lenta en los 4 modelos MoE medidos, entre un 20 % y un 75 % |
| ¿Qué sí ayudó? | Afinar la CPU (de +4 % a +15 %) y, al editar código, la técnica ngram-mod (hasta +37 %) |
| ¿Se puede ejecutar un modelo de 125B en 14 GB de VRAM + 32 GB de RAM? | Sí. Qwen3.8-Flash-Next, en una versión muy comprimida, dio unos 14 tokens por segundo |
| ¿Y programa bien? | Tardó 60 minutos. La ruleta funciona, pero los textos salieron en inglés y con errores |
| ¿Merece la pena para un usuario? | Con este hardware, no. Un modelo de 26-35B que quepa entero va más rápido y termina antes |
Cuatro modelos MoE y uno denso · llama.cpp del motor de LM Studio 2.63 · RTX 2080 SUPER + RTX 2060 · 32 GB de RAM · una medición por configuración.
Antes de empezar: cinco ideas sencillas
Si no has trabajado con modelos locales, estos conceptos te harán falta para seguir el resto. Los explico con analogías.
- Modelo MoE (mezcla de expertos). Imagina una biblioteca con 512 especialistas. Para cada palabra que el modelo escribe, solo consulta a unos 10. El modelo «pesa» mucho, porque guarda a todos, pero trabaja poco por palabra. Por eso un MoE grande puede ir rápido.
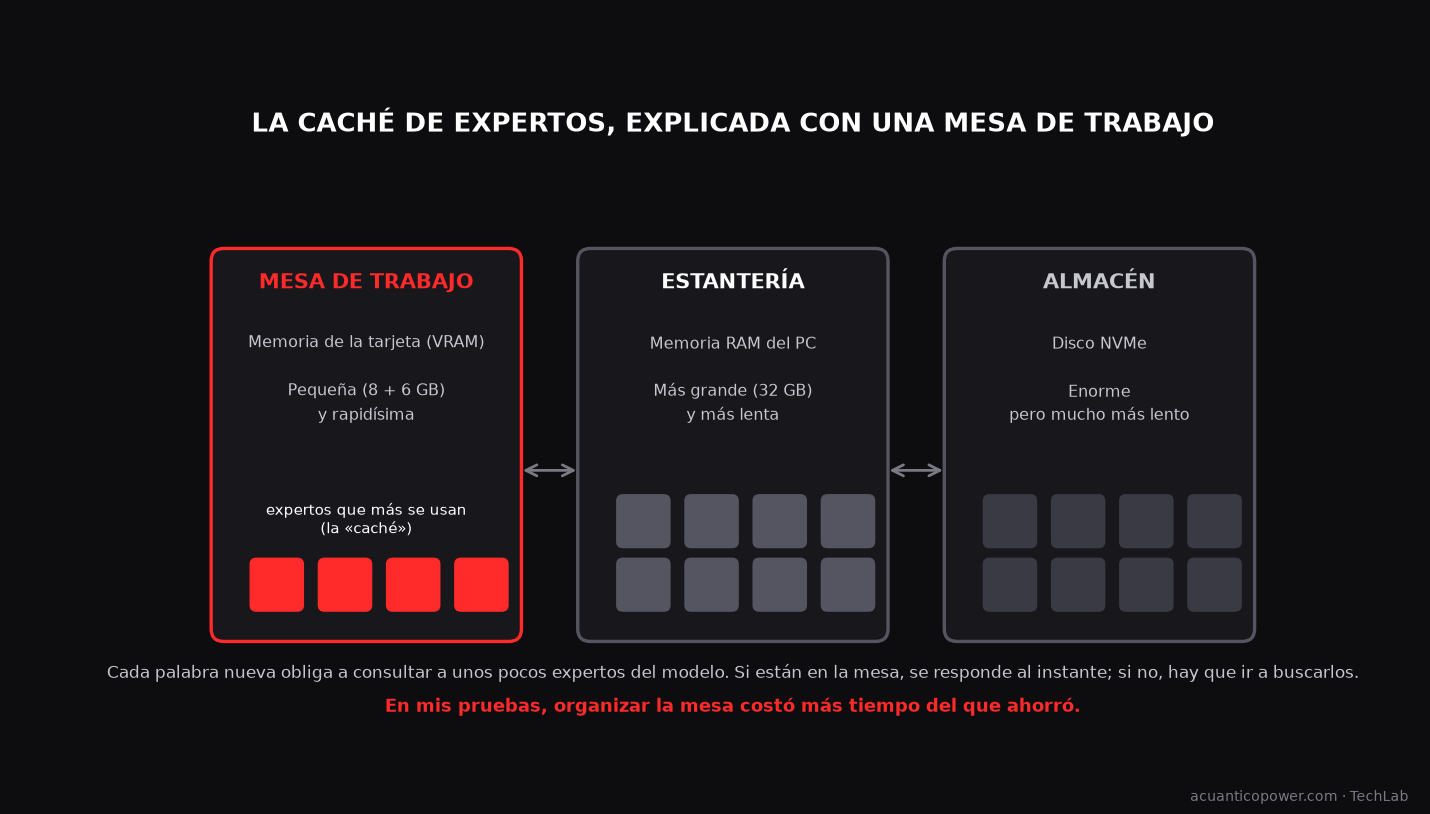
- VRAM, RAM y disco. Son tres sitios donde guardar el modelo. La VRAM, la memoria de la tarjeta gráfica, es una mesa de trabajo: rapidísima, pero pequeña. La RAM del PC es una estantería: cabe más y tarda más en alcanzarla. El disco es el almacén: enorme, pero lo más lento.
- Tokens por segundo (tok/s). Un token es un trocito de palabra. Unos 10 tok/s equivalen a unas 7 palabras por segundo, casi lo que lees con comodidad. Por debajo de 5 tok/s, esperar se hace pesado.
- Cuantización. Es comprimir el modelo para que ocupe menos, como guardar una foto en JPG de menor calidad. Cuanto más comprimido, más cabe… y menos fino es. Se mide en bits: 4 bits es lo normal; 1-2 bits es una compresión extrema.
- Caché de expertos. Dejar siempre sobre la mesa de trabajo (la VRAM) los especialistas que más se consultan, para no ir a buscarlos a la estantería o al almacén cada vez.
Sobre el papel es una buena idea. Veamos qué pasó en la práctica.
Qué quería probar
En mi equipo, Strata llegó a unos 21 tok/s con su versión comprimida de Qwen3.8-Flash-Next (125B), acertando el 64 % de las veces con los expertos que tenía en la mesa. La velocidad no era el problema.
Lo que me interesaba era el mecanismo, no la aplicación. Y llama.cpp ya lo trae: la opción --moe-cache-mib, fusionada el 7 de octubre de 2026, está en el motor de LM Studio desde la versión 2.58, aunque sin ajuste en su interfaz.
La pregunta era: ¿puedo conseguir lo mismo que Strata con las herramientas que ya uso?
Los archivos Gyro de Strata, su formato de compresión propio, no se pueden cargar con el llama.cpp normal, así que tenía que usar modelos GGUF estándar.
Lo nuevo en el laboratorio: Adolfo-Turing-Power
Para probarlo creé un agente nuevo dentro de Agente Jiménez. Es el único que habla con este servidor especial, y no toca ni LM Studio ni al resto de agentes.
- Un servidor propio de llama.cpp, accesible solo desde mi PC y con una clave distinta en cada arranque.
- Un selector de modelo y presets guardables, para cambiar de configuración con un clic.
- Todos los ajustes que quería comparar: caché de expertos, expertos fijos en la segunda tarjeta, decodificación especulativa (
ngram-mod,draft-mtp), CPU afinada y muestreo. - OpenCode integrado: le doy una carpeta y una tarea, y el modelo programa en ella sin heredar mi configuración personal.
- Un banco de pruebas que mide la velocidad y comprueba si el código generado funciona.
Cómo medí
Siempre igual: contexto de 8.192 tokens, sin razonamiento, temperatura 0 y tres peticiones cortas (explicar algo, escribir una función, editar código).
Anoto los tok/s al generar con el modelo ya «caliente». El primer intento sale más lento porque el archivo aún no está en la memoria del sistema: a Flint le pasó de 14,6 a unos 36 tok/s.
CPU afinada significa ajustar cuántos hilos usa el procesador y su prioridad. ngram-mod es un truco: el modelo «adivina» trozos que ya aparecieron en el texto y los comprueba de golpe. Es muy útil al editar código y poco al escribir algo nuevo.
Una pasada por cada configuración, así que son datos útiles, no estadística.
Resultados de velocidad
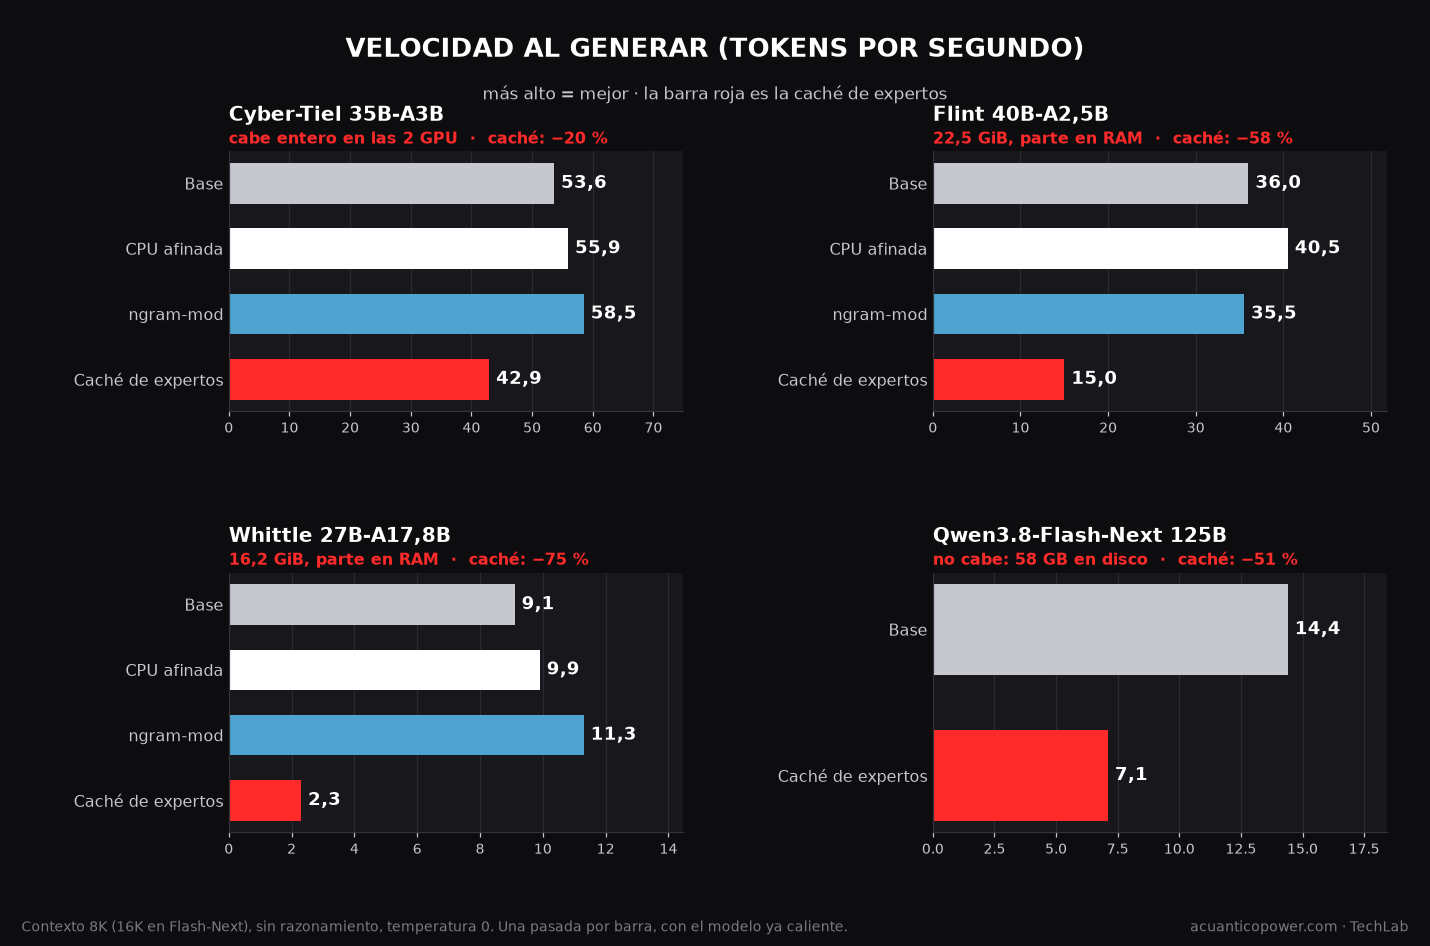
| Modelo | Base | CPU afinada | ngram-mod | Caché de expertos |
|---|---|---|---|---|
| Cyber-Tiel 35B-A3B NanoPlus (12,3 GiB) | 53,6 | 55,9 | 58,5 | 42,9 |
| Flint 40B-A2,5B Q4_K_M (22,5 GiB) | ~36 | 40,5 | 35,5 | 15,0 (4096 MiB) · 22,2 (8192 MiB) |
| Whittle-MoE 27B-A17,8B Q4_K_M (16,2 GiB) | 9,1 | 9,9 | 11,3 | 2,3 |
| Qwen3.8-27B Q3_K_M (denso, sin expertos) | 5,4 | 6,2 | 7,4 | — |
Tokens por segundo al generar; más alto es mejor.
En cristiano: si el modelo cabe en tus tarjetas, déjalo en automático y no toques la caché. Lo único que mejoró de forma fiable fue afinar la CPU, y ese cambio no altera lo que escribe el modelo: en Flint el texto salió idéntico.
La caché de expertos empeora siempre
Incluso con Flint, que tiene parte del modelo en RAM y es el caso donde más debería ayudar, pasó de ~36 a 15-22 tok/s.
Fijar los expertos en la segunda tarjeta es peor aún
19,1 tok/s en Cyber-Tiel y 13,3 en Flint. Mover datos entre las dos tarjetas por el bus del PC cuesta más de lo que se gana.
ngram-mod es desigual
Llegó a 68,8 tok/s al editar código con Cyber-Tiel, pero con Flint no aportó nada.
El modelo denso mejoró con otra técnica
Qwen3.8-27B ganó un 63 % con draft-mtp, hasta 8,8 tok/s. Si la combinas con la CPU estricta, se hunde a 2,0: no las mezcles.
Una trampa que me costó tiempo: si fijas a mano cuántas capas van a la GPU (--gpu-layers), llama.cpp deja de ajustarse solo y puedes quedarte sin memoria. Con Qwen3.8-27B, forzarlo dio error; dejándolo en automático, funcionó.
El modelo grande: 125B en 14 GB de VRAM
Si la caché iba a servir de algo, sería con un modelo que no cabe en memoria.
Elegí Qwen3.8-Flash-Next, el modelo de Strata, en una versión de ISTA-DASLab llamada GSQ-RCO Coder IQ1_M. Está «podada»: le han quitado la mitad de los especialistas, hasta quedarse con 256 de 512 por capa. Y comprimida a menos de 2 bits.
Se descarga en dos archivos, 58,4 GB en total. El primero (29,6 GB) son los pesos y tiene que estar en memoria. El segundo (28,8 GB) es una tabla que llama.cpp lee del disco cuando la necesita.
| Configuración con Qwen3.8-Flash-Next Coder IQ1_M | tok/s |
|---|---|
| Base (reparto automático + CPU afinada), contexto 16K | ~14,4 |
| Con caché de expertos de 4096 MiB | ~7,1 |
| Expertos en RAM + caché de 6144 MiB | no llegó a cargar |
Un modelo de unos 117.000 millones de parámetros (125.000 antes de podarlo) en un equipo con 14 GB de VRAM, cargando en 40 segundos y respondiendo a unos 14 tok/s. Eso es nuevo y es bueno.
La caché, otra vez, redujo la velocidad a la mitad. Solo probé un tamaño. El propio aviso del proyecto habla de regresiones con dos tarjetas y de ganancias pequeñas, y mis cifras van en esa línea.
La ruleta, otra vez
Repetí la tarea del primer artículo con OpenCode: una ventana con una ruleta de ocho premios que gira, se frena poco a poco, muestra el premio ganador y bloquea el botón mientras gira.
El prompt es el mismo, con los ocho premios en castellano, con tildes y entre comillas. Esto es lo que hizo cada modelo.
| Qué se pedía | Flint | Ornith-1.5 | Qwen3.8-Flash-Next |
|---|---|---|---|
| ¿Compila? | ✔ | ✔ | ✔ |
| ¿Gira la ruleta? | ✘ (solo se mueve el texto) | ✘ (se rompe al pulsar) | ✔ |
| ¿El botón se bloquea y se reactiva? | ✔ | ✘ (se queda bloqueado) | ✔ |
| ¿Muestra el premio? | ✔ (con el «Ganas» duplicado) | ✘ | ✔ |
| ¿Textos en castellano? | ✔ (sin tildes) | ✔ | ✘ (en inglés) |
| Tiempo | 6 min | 25 min | 60 min (el límite) |
Flint (40B-A2,5B): los sectores se quedan quietos
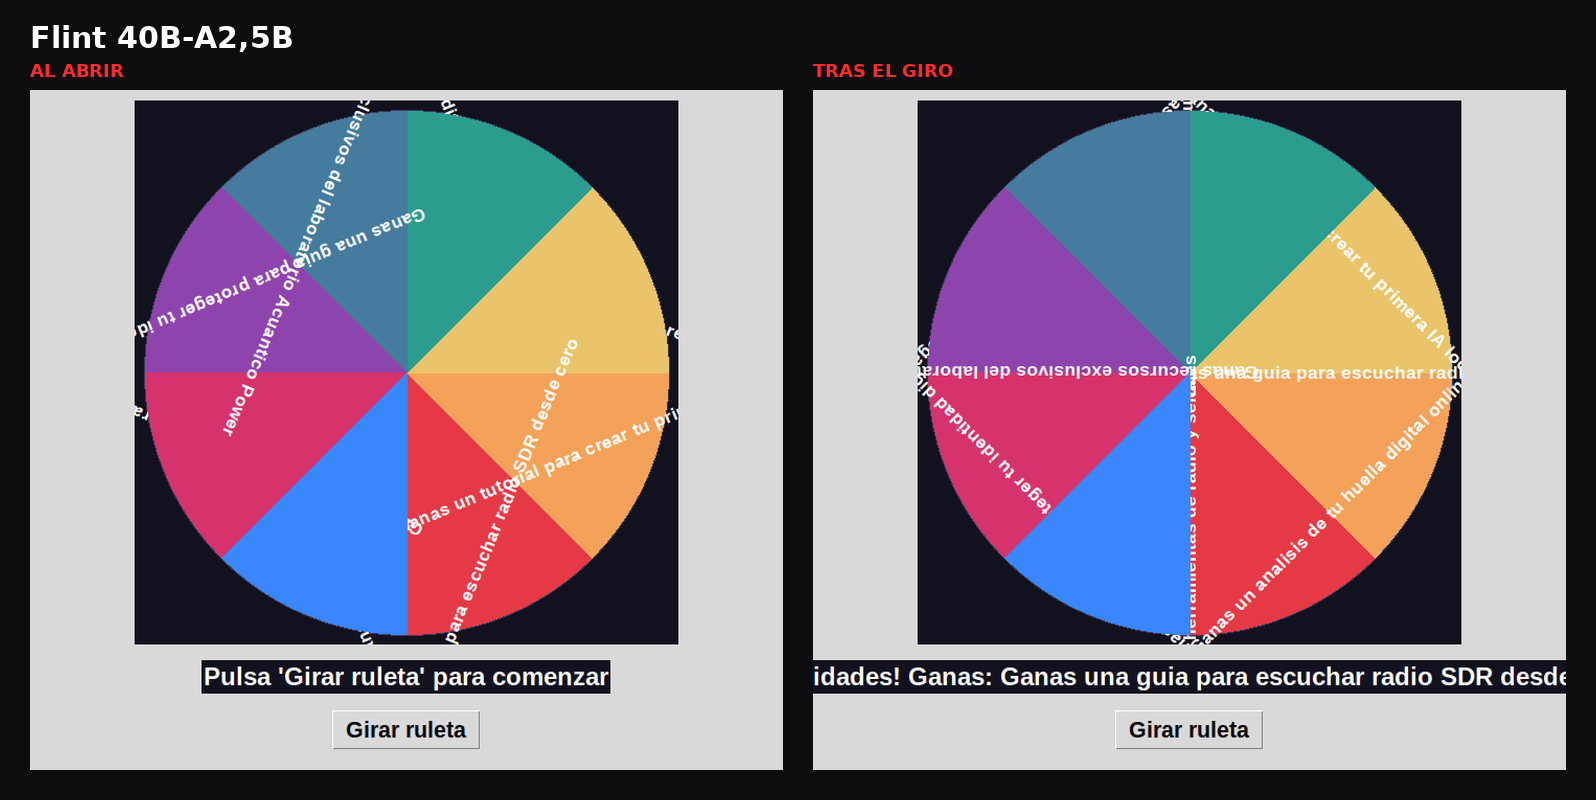
Se ve a simple vista: el modelo olvidó aplicar el giro a los colores. Solo se mueve el texto, que acaba flotando fuera de su sector.
Ornith-1.5 (35B-A3B): se rompe al pulsar
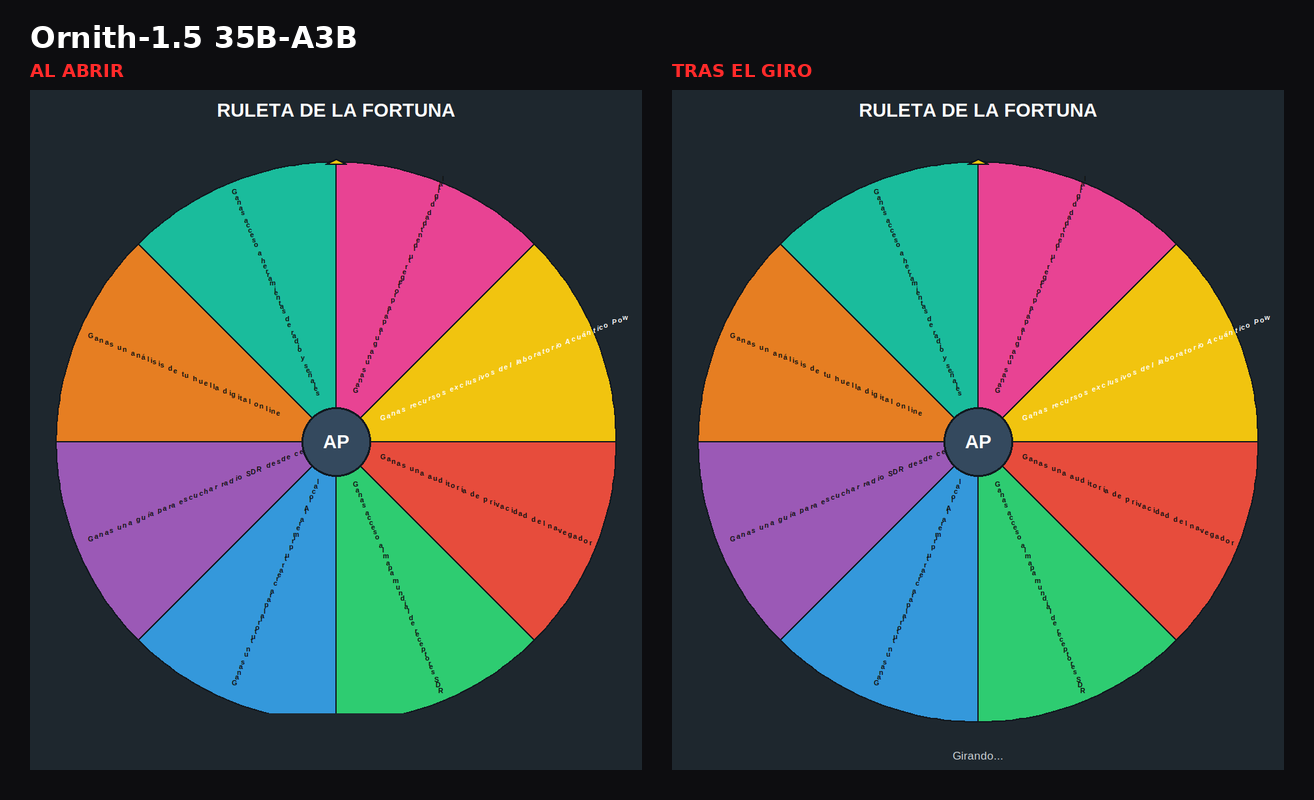
Al pulsar el botón el programa lanza un error: usó una función de Tkinter como si devolviera la hora, y no devuelve nada. La ventana se queda en «Girando…» para siempre.
Además, se le acabó el contexto mientras intentaba corregirlo.
Qwen3.8-Flash-Next (125B): funciona, pero en inglés
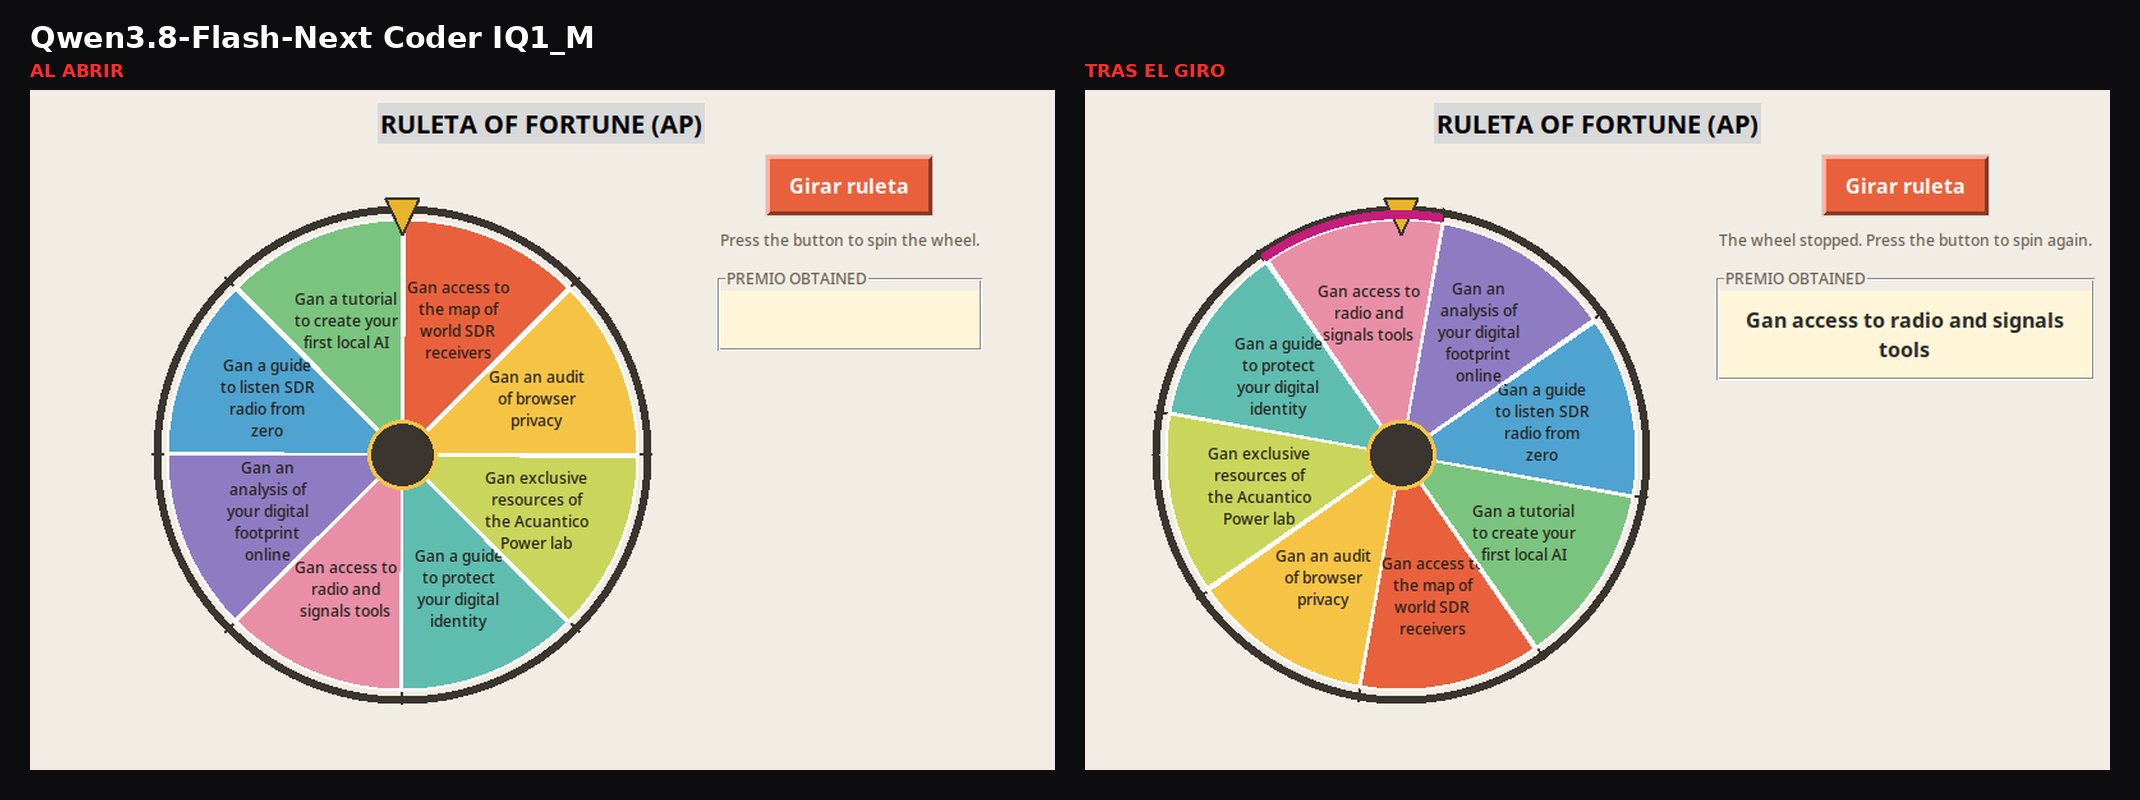
Es el mejor de los tres: la ruleta gira, el botón se bloquea, se detiene en 2,7 segundos y se reactiva. Y aun así no me vale.
Mi prompt estaba en castellano, y el modelo reescribió los premios en un inglés roto:
PRIZES = [
    "Gan an audit of browser privacy",
    "Gan access to the map of world SDR receivers",
    "Gan a tutorial to create your first local AI",
    ...
]
El título de la ventana es RULETA OF FORTUNE (AP), y el README también está en inglés («PREMIO OBTAINED»). Es un error que cualquier lector detecta en un segundo.
No sé por qué lo hizo. La hipótesis más razonable es la compresión extrema, menos de 2 bits, y la poda de especialistas: la ficha del modelo admite que la degradación fuera del código «es un coste aceptado». Pero es una hipótesis, no un dato.
Además, tardó una hora. Gran parte se fue en razonar y en intentar ver la ventana sin tener ningún visor, no en escribir código.
Trampas del flujo
- OpenCode leyó mi configuración personal y me denegó las escrituras de la tarea, porque tenía reglas de otro proyecto. Hay que aislar sus carpetas y desactivar la lectura de la configuración de usuario.
- Un contexto de 32K es poco. La primera petición ya ocupaba 34.005 tokens. Necesité 65K, y con Ornith ni siquiera bastó.
- A veces parece que falla el modelo cuando falla el flujo. Mi primera ruleta con Flint salió peor en parte por mi prompt, que prohibía ejecutar el programa y solo dejaba compilarlo.
¿Merece la pena para un usuario?
| Si tienes… | Mi recomendación |
|---|---|
| Una GPU de 8 GB (más una segunda barata) y 32 GB de RAM | Un MoE de 26-35B que quepa entero, como Gemma 4 26B-A4B o Cyber-Tiel, del primer artículo. Es lo más rápido y lo que termina la tarea |
| Curiosidad por los modelos enormes | Es posible (125B a 14 tok/s), pero hoy cuesta mucho tiempo y calidad en programación autónoma |
| Ganas de ajustar | Afina la CPU, deja el reparto de GPU en automático y usa ngram-mod solo si tu agente edita mucho |
| Tentación por la caché de expertos | Pruébala con tu modelo, pero no la des por buena: en mi equipo perdió siempre |
Qué no he medido
- Una sola ejecución por modelo y configuración, y un flujo distinto al del primer artículo: aquí una tarea de OpenCode de un solo disparo; allí el pipeline de Agente Jiménez con verificación y reintentos. Los tiempos no son comparables.
- La caché se probó con pocos tamaños (1536, 4096 y 8192 MiB; con 6144 no cargó). En otro equipo, con más VRAM o con un modelo mucho mayor que la RAM, puede comportarse mejor.
- La calidad se mide con una sola tarea, la ruleta, y la he juzgado yo.
- Qwen3.8-Flash-Next está podado y comprimido a menos de 2 bits. No refleja cómo es el modelo original.
Qué me llevo
La novedad más llamativa, que modelos enormes quepan en una tarjeta pequeña, funciona. Pero no se traduce en un agente de programación mejor.
La velocidad ya no es el cuello de botella. Lo es la fiabilidad del modelo en tareas largas.
Si quieres el contexto completo, qué es un agente, cómo participa cada GPU y por qué los MoE fueron los únicos en terminar la tarea, léelo en el primer artículo. Esta prueba lo complementa.
Si te ha servido, invítame a un café
Estas pruebas se llevan horas de máquina y decenas de gigas de modelos que descargo, mido y borro. Lo único que no sé generar en local es el café.
Si este artículo te ha ahorrado probarlo tú, puedes invitarme a uno.
Cada prueba lleva horas de máquina y decenas de gigas que bajo, mido y borro. Un café ayuda a seguir haciéndolas.
☕ Invítame a un café en Ko-fiSigue explorando la IA local
- Programación autónoma con IA local, la prueba de la que este artículo es continuación.
- Música con IA local en 8 GB, otra prueba de hasta dónde llega una gráfica de 8 GB.
- ¿Cuál es el mejor modelo de IA local? 13 modelos frente a 1.080 pruebas.
- IA local por dentro: qué hay realmente detrás de un agente de inteligencia artificial.
- IA local frente a la nube: privacidad, potencia y límites reales.
Preguntas frecuentes
¿Qué hace --moe-cache-mib?
Reserva memoria de la tarjeta gráfica para mantener los expertos más usados de un modelo MoE cuyo resto está en RAM. En teoría evita traer los mismos expertos una y otra vez. En mi equipo fue más lenta en los cuatro modelos MoE probados.
¿Puedo ejecutar un modelo de 125B con 14 GB de VRAM?
Sí, si el archivo está muy comprimido y una parte se lee del disco. Yo lo conseguí con 32 GB de RAM y unos 14 tok/s, con una versión podada y comprimida a menos de 2 bits.
¿Por qué no usaste los archivos Gyro de Strata?
Porque no los carga el llama.cpp normal; necesitan Strata o una bifurcación propia. Yo quería comprobar qué se podía hacer con el motor que ya trae LM Studio.
¿Merece la pena comprar más memoria o una segunda tarjeta para esto?
Para programar con agentes, un modelo de 26-35B que quepa entero rindió mejor que uno de 125B muy comprimido. El primer artículo mide qué aporta una segunda tarjeta.
¿Por qué la ruleta en inglés es un problema?
Porque el prompt pedía los textos en castellano, con tildes. Un modelo que cambia el idioma de lo que se le pide no es fiable para tareas largas sin supervisión.